Введение
Данная статья - практикум к серии «Введение в архитектуру ПО». Речь в ней пойдёт об инверсии зависимостей: как этот приём выглядит в обычном проекте на Java и Spring - распространённом фреймворке для серверных приложений.
Дальше в статье часто упоминаются два термина: бизнес-правила и хранилище. Давайте дадим им определение.
Бизнес-правила (их ещё называют бизнес-логикой) - код, который принимает решения по условиям задачи: можно ли записать пользователя ещё на один учебный курс, если он уже проходит три, положена ли покупателю скидка, пора ли закрывать заказ. Сами условия придумывает не программист. Их задают те, кто отвечает за продукт, исходя из того, как устроено дело, которое обслуживает приложение.
Хранилище - код, который кладёт данные в базу и достаёт их обратно. В проекте на Java это класс или интерфейс с методами вроде «найти по идентификатору», «сохранить», «удалить».
Правилам почти всегда нужно хранилище. Чтобы решить, можно ли записать пользователя на курс, надо сначала узнать, на сколько курсов он уже записан, а это знает только база. В упрощённом виде такой код выглядит так:
class EnrollmentRules {

    private final PostgresParticipationStore store;

    EnrollmentRules(PostgresParticipationStore store) {
        this.store = store;
    }

    boolean canEnroll(long userId) {
        return store.countActiveCourses(userId) < 3;
    }
}
В классе EnrollmentRules находится правило «не больше трёх активных курсов». PostgresParticipationStore - класс хранилища: он отправляет SQL-запрос в базу PostgreSQL и возвращает число. Имя этого класса стоит в коде правил дважды: в типе поля и в параметре конструктора. О такой связи говорят, что правила зависят от хранилища: без класса PostgresParticipationStore файл с правилами не скомпилируется, а любое изменение в объявлениях его методов отзовётся в правилах.
Инверсия зависимостей переворачивает эту связь. Правила сами объявляют интерфейс - перечень операций, которые им нужны, - и дальше работают только с ним:
// Объявлен в том же пакете, что и правила
interface ParticipationStore {
    int countActiveCourses(long userId);
}

class EnrollmentRules {

    private final ParticipationStore store;

    EnrollmentRules(ParticipationStore store) {
        this.store = store;
    }

    boolean canEnroll(long userId) {
        return store.countActiveCourses(userId) < 3;
    }
}
Класс PostgresParticipationStore никуда не делся, и SQL-запрос в нём прежний. Поменялось его объявление: теперь это class PostgresParticipationStore implements ParticipationStore. Класс хранилища реализует интерфейс, который составили правила, то есть содержит код всех его методов.
Сравним два листинга. Во время работы приложения правила по-прежнему вызывают хранилище, и запрос по-прежнему уходит в базу - здесь ничего не изменилось. Изменилось другое: чьё имя записано в чьём коде. Раньше код правил упоминал класс хранилища. Теперь он его не упоминает вовсе, а код хранилища, наоборот, упоминает интерфейс правил. Зависимость развернулась против направления вызова - отсюда и название приёма.
Даёт это две вещи. Первая: правилам можно передать любой класс, который реализует интерфейс. В работающем приложении это настоящее хранилище, а в тесте - хранилище в памяти, то есть обычный список объектов. Тогда для проверки правила «не больше трёх» не придётся «поднимать базу», то есть запускать сервер базы данных ради теста. Вторая: хранилище можно переписать - поменять запрос, перейти на другую базу, - и файл с правилами даже не придётся открывать, пока интерфейс остаётся прежним.
В предыдущей статье в блоге из серии статей про архитектуру, этот приём разобран подробно, и разбор там заканчивается оговоркой: «Приём несложен. Возможно, поэтому его часто применяют формально, не получая обещанного результата». Обещанный результат - те две вещи, что названы абзацем выше. Формальное применение - это когда интерфейс в коде есть, а правила всё равно привязаны к устройству базы: интерфейс объявлен не рядом с правилами, тянет за собой типы фреймворка или открывает правилам операции, которые им не нужны. Как такое получается в живом проекте и как этого избежать - давайте об этом и поговорим.
В проекте на Spring приём сразу упирается в вопрос, которого в схеме выше нет. Класс хранилища там обычно не пишут вовсе. Вместо него объявляют интерфейс-наследник JpaRepository из библиотеки Spring Data, и при запуске приложения библиотека сама создаёт класс, который этот интерфейс реализует. В созданном классе сразу есть готовые операции с таблицей: сохранить объект в строку, найти строку по идентификатору, удалить, посчитать строки, выдать список по страницам - всего около трёх десятков.
Отсюда и вопрос: если правила объявят собственный интерфейс, что делать с готовыми операциями? Отказаться от них и написать хранилище руками? Как-то связать свой интерфейс с тем, что создаёт библиотека? Или ничего не менять? От ответа зависит, сколько кода придётся написать и потом поддерживать и сколько сведений о базе - имён таблиц, колонок, связей между ними - останется в коде правил.
Мы разберём три варианта ответа на одном сквозном примере.
Привычный - тот, что получается в проекте на Spring сам собой: интерфейс Spring Data подключается прямо к коду правил, собственного интерфейса у правил нет.
С отдельной моделью - разделение до конца. Моделью называют набор классов, которыми приложение описывает свои данные. Здесь у правил своя модель - собственные классы без единого упоминания таблиц и колонок, - а вдобавок собственный интерфейс к хранилищу.
Переходный - промежуточный между ними: собственный интерфейс у правил уже есть, а классы данных остаются теми же, что описывают таблицы.
Для каждого варианта посмотрим, что он даёт и во что обходится. Затем - как выбрать вариант для нового проекта, как сделать, чтобы разделение не стёрлось через полгода правок, и как перейти от одного варианта к другому, не останавливая работу над задачами.
Задача
Пример для всей статьи - образовательная платформа. Устроена она так.
Программа - описание курса: чему учат и в каком порядке. Запуск курса - конкретная группа, которая проходит программу в свои даты: например, «Java для начинающих, группа с 1 марта». У одной программы бывает много запусков. Пользователь записывается на запуск; «записаться на курс» на платформе означает именно это: записаться на конкретный запуск. Каждая запись находится в одном из трёх состояний: активная (человек учится), отменённая (передумал) или пройденная (закончил курс).
На записи действуют два правила. Первое: одновременно активных курсов у пользователя не больше трёх, и попытка записаться на четвёртый заканчивается отказом. Второе: запись на пройденный курс отменить нельзя. Правила короткие, но по каждому приложение принимает решение - записать или отказать, отменить или нет, - и это делает их бизнес-правилами в том смысле, что дан во введении.
Есть на платформе и задача, в которой ничего не решается: экран «мои курсы» показывает пользователю его записи с названиями программ. Здесь ничего не проверяется: что лежит в базе, то и выводится.
Запись на курс дальше будет называться объектом предметной области. Предметная область - то дело, которое обслуживает приложение; здесь это обучение. Объект предметной области - понятие из этого дела, у которого есть собственные правила. У записи они есть: лимит в три курса и запрет отменять пройденное.
Начнём с классов, которые описывают данные платформы. В проекте на Spring их обычно пишут с аннотациями JPA. JPA - стандарт Java для работы с базой данных через обычные объекты: класс помечают аннотациями, и библиотека сама превращает его объекты в строки таблицы и обратно. Такой класс называют сущностью. Вот сущности платформы:
@Entity
@Table(name = "course_participation")
public class CourseParticipation {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @ManyToOne(fetch = FetchType.LAZY)
    @JoinColumn(name = "user_id", nullable = false)
    private User user;

    @ManyToOne(fetch = FetchType.LAZY)
    @JoinColumn(name = "course_run_id", nullable = false)
    private CourseRun courseRun;

    @Enumerated(EnumType.STRING)
    @Column(nullable = false)
    private ParticipationStatus status;

    @Column(name = "enrolled_at", nullable = false)
    private Instant enrolledAt;

    public CourseParticipation() { }   // конструктор без параметров нужен JPA

    // геттеры и сеттеры на все поля опущены
}

@Entity
@Table(name = "course_run")
public class CourseRun {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @ManyToOne(fetch = FetchType.LAZY)
    @JoinColumn(name = "program_id", nullable = false)
    private Program program;

    @Column(name = "starts_on", nullable = false)
    private LocalDate startsOn;

    protected CourseRun() { }
    // геттеры и сеттеры опущены
}

@Entity
@Table(name = "users")
public class User {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @Column(nullable = false)
    private String email;

    protected User() { }
    // геттеры и сеттеры опущены
}

@Entity
@Table(name = "program")
public class Program {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @Column(nullable = false)
    private String title;

    protected Program() { }
    // геттеры и сеттеры опущены
}

public enum ParticipationStatus { ACTIVE, CANCELLED, COMPLETED }
Аннотации здесь делают следующее. @Entity объявляет класс сущностью, @Table называет таблицу, в строках которой лежат его объекты. @Id помечает поле-идентификатор, а @GeneratedValue говорит, что значение идентификатора назначит сама база при вставке строки. @Column задаёт имя колонки, если оно отличается от имени поля, и запрещает пустое значение (nullable = false). @ManyToOne вместе с @JoinColumn описывают связь: у многих записей может быть один и тот же пользователь и один и тот же запуск курса, а в таблице каждая такая связь хранится колонкой с идентификатором: user_id для пользователя и course_run_id для запуска. Параметр fetch = FetchType.LAZY просит не читать связанный объект из базы, пока к нему не обратятся. @Enumerated(EnumType.STRING) сохраняет состояние записи словом (ACTIVE, CANCELLED, COMPLETED), а не порядковым номером.
Всё, что аннотации сообщают о таблице, - её имя, имена колонок, связи, способ хранить состояние и получать идентификатор, - дальше в статье называется разметкой таблицы.
Остальное в этих классах продиктовано тем, как JPA создаёт объекты. Сначала библиотека вызывает конструктор без параметров и получает пустой объект, потом записывает в его поля значения из строки таблицы. Поэтому конструктор без параметров обязателен, а поля не могут быть объявлены final. У CourseParticipation этот конструктор открытый (public), потому что новые записи создаёт ещё и код приложения; остальным сущностям хватает protected: JPA этого достаточно. Сеттеры - методы, меняющие значение поля, - самой JPA здесь не нужны: аннотации стоят на полях, и JPA читает и записывает поля напрямую. Нужны они коду приложения, который заполняет новую запись по частям.
Теперь код, который работает с этими классами. В проекте на Spring он обычно выглядит так:
public interface CourseParticipationRepository
        extends JpaRepository<CourseParticipation, Long> {

    @Query("select p from CourseParticipation p "
         + " join fetch p.courseRun r "
         + " join fetch r.program "
         + " where p.user.id = :userId")
    List<CourseParticipation> findAllForUser(@Param("userId") Long userId);
}

public interface CourseRunRepository extends JpaRepository<CourseRun, Long> {
}

public interface UserRepository extends JpaRepository<User, Long> {
}
@Service
public class ParticipationService {

    private final CourseParticipationRepository participations;
    private final CourseRunRepository courseRuns;
    private final UserRepository users;

    public ParticipationService(CourseParticipationRepository participations,
                                CourseRunRepository courseRuns,
                                UserRepository users) {
        this.participations = participations;
        this.courseRuns = courseRuns;
        this.users = users;
    }

    @Transactional
    public CourseParticipation enroll(Long userId, Long courseRunId) {
        List<CourseParticipation> all = participations.findAllForUser(userId);

        long active = all.stream()
            .filter(p -> p.getStatus() == ParticipationStatus.ACTIVE)
            .count();

        if (active >= 3) {
            throw new IllegalStateException("Слишком много активных курсов");
        }

        CourseParticipation participation = new CourseParticipation();
        participation.setUser(users.getReferenceById(userId));
        participation.setCourseRun(courseRuns.getReferenceById(courseRunId));
        participation.setStatus(ParticipationStatus.ACTIVE);
        participation.setEnrolledAt(Instant.now());

        return participations.save(participation);
    }
}
JpaRepository - интерфейс из Spring Data. Достаточно объявить его наследника и указать в угловых скобках класс сущности и тип её идентификатора - и реализацию писать не нужно: Spring Data создаст её при запуске приложения. Такие интерфейсы хранилища в Spring называют репозиториями.
Созданные реализации Spring сам передаёт в конструктор ParticipationService: сервис их не создаёт, а получает готовыми. Это называется внедрением зависимостей, и аннотация @Service как раз сообщает Spring, что объект этого класса нужно создать при запуске и передать ему всё, что перечислено в конструкторе. Название похоже на инверсию зависимостей, но речь о другом. Внедрение отвечает на вопрос, кто создаёт объект и передаёт его тому, кто им пользуется. Инверсия - на вопрос, чьё имя записано в чьём коде.
Аннотация @Query содержит запрос, который Spring Data выполнит при вызове метода. Запрос написан на JPQL - языке запросов JPA. Он похож на SQL, но обращается не к таблицам и колонкам, а к классам и их полям, поэтому в нём стоят CourseParticipation и p.user.id. @Param("userId") связывает параметр метода с именем :userId внутри запроса.
join fetch просит прочитать связанные записи - запуск курса и его программу - тем же запросом. Без этого связи с пометкой LAZY читались бы по одной, в момент обращения: список из двадцати записей дал бы один запрос за сам список и ещё по запросу на каждый запуск и каждую программу. Чтение связей по требованию называют ленивой загрузкой, а лавину мелких запросов, которую она порождает, - проблемой N+1: один запрос за список и N дополнительных.
Метод findAllForUser обслуживает обе задачи платформы сразу. Сервис записи берёт из него записи пользователя, чтобы посчитать активные, а экран «мои курсы» - чтобы показать список с названиями программ. Поэтому в запросе подтягивается и программа, хотя правилу про три курса она не нужна.
Аннотация @Transactional означает «выполни метод внутри одной транзакции». Транзакция - группа изменений в базе, которая применяется целиком или не применяется вовсе: если метод упадёт посередине, ни одно его изменение в базу не попадёт.
Наконец, getReferenceById возвращает объект-ссылку по идентификатору, не читая строку из базы. Новой записи на курс нужно знать только, какой пользователь и на какой запуск записан; содержимое этих объектов ей не нужно. Ради двух таких ссылок в сервис внедрены ещё два репозитория: UserRepository и CourseRunRepository.
Осталось сказать, как этот код разложен по проекту. В привычном варианте это обычно один модуль сборки, а классы разнесены по пакетам. Пакет - группа классов с общим началом полного имени, например com.example.courses.service; в Java он совпадает с папкой. Все пакеты ниже лежат внутри com.example.courses:
пакет         что внутри                                 от каких пакетов зависит
model         сущности с @Entity, ParticipationStatus    ни от каких
repository    интерфейсы Spring Data                     model
service       ParticipationService с правилами           model, repository
web           контроллеры                                service, model
В последнем столбце перечислены только пакеты этого же проекта. От библиотек они зависят каждый по-своему: model - от JPA, repository - от Spring Data.
Главное в этой раскладке - третья строка. Пакет с правилами (service) зависит от пакета с репозиториями (repository): стрелка идёт от правил к хранению, так же как в первом листинге введения, до инверсии. А через model правила зависят ещё и от разметки таблиц. Следить за тем, кто от кого зависит, здесь некому: модуль один, и все открытые классы видны друг другу.
Этот код работает: собирается, запускается и выполняет требования задачи. Менять его мы будем не потому, что он неправильный, а потому, что у него есть четыре следствия, которые проявляются по мере роста проекта. Их и разберём.
Привычный вариант
Прежде чем разбирать следствия, перечислим, что этот вариант даёт. Без этого не видно, от чего придётся отказываться, если его менять.
Готовые операции. В CourseParticipationRepository объявлен один метод - findAllForUser. Остальные интерфейс получил по наследству от JpaRepository, и сервис может вызывать их сразу, не написав ни строки реализации:
participations.save(participation);
participations.findById(id);
participations.existsById(id);
participations.count();
participations.deleteById(id);
Здесь пять из них: сохранить запись, найти её по идентификатору, проверить наличие записи с таким идентификатором, посчитать строки в таблице и удалить запись. Кроме них есть выдача по страницам и с сортировкой, поиск по образцу, удаление пачкой и другие. Если сложить объявления по документации Spring Data, получится так: двенадцать у самого JpaRepository, двенадцать он наследует от CrudRepository, два - от PagingAndSortingRepository, семь - от QueryByExampleExecutor. Чуть больше тридцати объявлений, три из них помечены как устаревшие. А запрос, которого среди готовых нет, добавляется одним методом с аннотацией @Query.
Один класс вместо двух. CourseParticipation описывает строку таблицы и одновременно служит объектом, с которым работает сервис. Второй класс с теми же полями не нужен, и не нужен код, который копировал бы значения полей из одного класса в другой.
Знакомое устройство. В проектах на Spring такой код встречается чаще других, его же показывают в документации и учебных примерах. Новый человек в команде, скорее всего, разберётся в нём без объяснений.
Это настоящие преимущества, и отказываться от них без причины незачем. Посмотрим теперь, что приходит вместе с ними.
Четыре следствия
Разберём их по одному.
Первое: сервис зависит от разметки таблицы. Сервис создаёт объекты CourseParticipation и читает их поля, а этот класс описывает таблицу. Поэтому изменения в способе хранения доходят до сервиса, даже если правила не менялись. Пример: решили хранить пользователя в записи не связью User user, а простым числом Long userId. Поменяется сущность - и вместе с ней строка participation.setUser(users.getReferenceById(userId)) в сервисе, то есть в файле, где записано правило про три курса. Само правило при этом останется прежним.
Второе: вместе с нужными операциями сервис получил все остальные. Для записи на курс сервису нужны две операции: прочитать записи пользователя и сохранить новую. Получил он, кроме них, deleteAll (удалить все записи в таблице), deleteAllInBatch (то же одним запросом), findAll (прочитать всю таблицу целиком) и ещё почти три десятка. Код, которому внедрён этот репозиторий, может вызвать любую из этих операций, и ни компилятор, ни тесты не спросят зачем. А репозиториев в сервисе три, и у каждого свой полный набор.
Третье: правило проверяется только через заглушку. Само правило - простая арифметика: посчитать активные записи и сравнить с тремя. Но записи сервис берёт из репозитория, а репозиторий ходит в базу. Поднимать базу ради проверки арифметики не хочется, поэтому в тесте вместо репозитория подставляют заглушку - объект, который выдаёт себя за репозиторий и возвращает заранее заготовленный список. Способ рабочий, но у него есть слабое место, и ему посвящён следующий подраздел.
Четвёртое: правило записано в сервисе. Проверка active >= 3 стоит внутри метода enroll. Пока путь записи на курс один, это незаметно. Появится второй путь (перенос с одного запуска на другой, запись администратором, загрузка списка сотрудников из файла) - и проверку придётся повторить там. Повторить или забыть. С запретом отменять пройденный курс то же самое. В коде выше его ещё нет, но и записать его, кроме сервиса, некуда: у сущности открыт сеттер setStatus, и перевести запись в отменённое состояние может любой код, минуя проверку.
У четырёх следствий есть общее: ни одно не следует из задачи. Правило «не больше трёх активных курсов» ничего не знает ни про колонки, ни про удаление пачкой, ни про устройство таблицы - оно считает записи. Следствия появились из того, как устроен код.
Разве моки не решают задачу?
Здесь уместно возражение. Заглушку не обязательно писать руками: в Java для этого есть библиотека Mockito. Заглушку, собранную библиотекой, называют моком. Класс для мока не пишут, а говорят библиотеке: «на такой вызов верни вот это». Базы мок не требует. Так в чём же слабое место?
Вот рабочий тест привычного варианта:
@ExtendWith(MockitoExtension.class)
class ParticipationServiceTest {

    @Mock CourseParticipationRepository participations;
    @Mock CourseRunRepository courseRuns;
    @Mock UserRepository users;

    @Test
    void не_даёт_записаться_на_четвёртый_курс() {
        when(participations.findAllForUser(1L))
            .thenReturn(List.of(active(), active(), active()));

        ParticipationService service =
            new ParticipationService(participations, courseRuns, users);

        assertThrows(IllegalStateException.class, () -> service.enroll(1L, 400L));
    }

    private CourseParticipation active() {
        CourseParticipation p = new CourseParticipation();
        p.setStatus(ParticipationStatus.ACTIVE);
        return p;
    }
}
Тест выполняется за миллисекунды, базы не требует и проверяет правило про три курса. С этой стороны к нему претензий нет.
Посмотрим внимательнее, что именно он проверил. Не «правило работает», а «если репозиторий вернёт три активные записи, сервис откажет в четвёртой». Первая половина фразы - предположение автора теста о том, что вернёт настоящий запрос. Сам запрос в тесте не выполняется, и предположение остаётся непроверенным.
Похоже на придирку. Проверим, во что она обходится на практике.
Вспомним, как устроен сервис: запрос возвращает все записи пользователя, а активные среди них отбирает сам сервис строкой .filter(p -> p.getStatus() == ParticipationStatus.ACTIVE). Сломаем сервис: удалим эту строку. Теперь он считает все записи подряд, включая отменённые, и будет отказывать тем, кому отказывать нельзя. Прогоним исправный и сломанный сервисы через две разные заглушки:
| Что отдаёт заглушка |
Активных записей |
Правильный ответ |
Сервис с фильтром |
Сервис без фильтра |
| три активные записи |
три |
отказать |
отказал |
отказал |
| две активные и две отменённые |
две |
записать |
записал |
отказал |
Первая строка - тот самый тест. На исправном и на сломанном коде он ведёт себя одинаково, то есть поломки не замечает. Увидеть её можно только во второй строке, и только если автор теста догадался положить в заглушку отменённые записи.
Дело не в Mockito. Заглушка, собранная любым способом, описывает представление автора теста о том, что вернёт запрос, и это представление ничем не проверяется. Таких представлений в проекте столько же, сколько тестов правила: каждый тест молча, составом заглушки, отвечает на вопрос «какие записи отдаст база». Ответы могут расходиться и между собой, и с настоящим запросом - и ни один тест об этом не сообщит.
Можно, конечно, дописать тест со второй строки таблицы, и эту поломку он поймает. Но поймает потому, что автор её предугадал: тест стал ещё одним предположением о запросе, просто более удачным.
Надёжнее другое. Если перенести отбор активных записей из сервиса в сам запрос к базе, у вопроса «правильно ли отбираются активные записи» появится одно место, где на него отвечают: тест, который выполняет запрос на настоящей базе. Тестам правила этот вопрос станет не нужен: они получают уже отобранные записи и проверяют только арифметику. Именно так будет сделано в следующих вариантах.
Есть ещё два отличия мока от собственной реализации хранилища, помельче. Мок подменяет интерфейс Spring Data, а тот возвращает сущности, поэтому тест правила собирает объекты-сущности и ломается, когда меняются объявления методов репозитория. И мок настраивается заново в каждом тесте, тогда как собственный интерфейс хранилища позволяет написать одну реализацию для всех тестов сразу; как она выглядит, показано в разделе о варианте с отдельной моделью.
Для специалистов с опытом: тест на настоящей базе в Spring обычно пишут с аннотацией @DataJpaTest. Она поднимает только слой хранения (репозитории и сущности), поэтому сервис в такой тест добавляют явно, аннотацией @Import. Выполняется такой тест секунды, а не миллисекунды, зато проверяет то, чего не видят ни мок, ни реализация в памяти: сам запрос, соответствие сущностей схеме таблиц, перенос значений из строк в объекты. Отвечает он на свой вопрос («отдаёт ли база правилу те записи, которых оно ждёт»), а не на вопрос «верно ли правило».
Вариант с отдельной моделью
В этом варианте правила записи на курс не знают, как устроено хранение. У них свой интерфейс к хранилищу и свои классы данных, в которых нет ни одной аннотации JPA и ни одного упоминания Spring. Классы с @Entity никуда не исчезают, но переезжают в код, который отвечает за базу. Название варианта говорит о главном отличии от двух других: у правил своя модель, у таблиц своя.
Чтобы граница между ними держалась сама, разложим код по четырём модулям сборки. Модуль сборки - это подпроект Maven: отдельная папка со своим файлом pom.xml, где перечислено, от каких библиотек и каких других модулей он зависит. Maven - распространённая система сборки для Java: она скачивает библиотеки, компилирует код и упаковывает результат. Обязательно ли делить код именно на модули сборки - вопрос отдельный; он разобран в разделе «Уровни строгости». Та же раскладка подойдёт и для переходного варианта, о котором речь пойдёт позже.
модуль                что внутри                        от каких модулей зависит
courses-domain        правила и интерфейс к хранилищу   ни от каких
courses-application   сценарии, транзакции              courses-domain
courses-persistence   сущности, Spring Data             courses-domain
courses-app           запуск приложения, веб-слой       от всех трёх
В последнем столбце перечислены только модули этого же проекта; внешние библиотеки у каждого модуля свои.
У модулей есть короткие названия, которые дальше встречаются постоянно.
Домен (от английского domain - «предметная область») - модуль courses-domain. В нём сама задача без способов её выполнения: класс записи на курс с правилами, которые касаются одной записи (например, с запретом отменять пройденный курс), и интерфейс, через который правила обращаются к хранилищу.
Сценарии - модуль courses-application. Сценарий - класс, который выполняет одно действие пользователя от начала до конца: получает просьбу «записать пользователя 1 на запуск 400», достаёт нужные данные, применяет правила и сохраняет результат. В привычном варианте эту работу делал ParticipationService, здесь её выполняет класс EnrollUser.
Инфраструктура - модуль courses-persistence: классы с @Entity, интерфейсы Spring Data и всё остальное, что умеет работать с базой.
Четвёртый модуль, courses-app, собирает приложение из трёх остальных и запускает его. В нём же лежит веб-слой - код, который принимает запросы из браузера и отправляет ответы.
Главное в этой раскладке - первая строка таблицы. В pom.xml доменного модуля нет ни Spring, ни JPA, ни драйвера базы данных. Поэтому написать в доменном коде @Entity невозможно даже случайно: компилятор не найдёт такую аннотацию. Направление зависимостей здесь держит файл сборки, а не договорённость в команде.
Доменный объект
Начнём с класса, с которым работают правила. Это CourseParticipation из доменного модуля - та же запись пользователя на запуск курса, только без единой аннотации. Доменным объектом дальше называется именно такой класс: объект предметной области, записанный кодом, который ничего не знает о хранении.
package com.example.courses.domain;

public final class CourseParticipation {

    private final ParticipationId id;
    private final UserId userId;
    private final CourseRunId courseRunId;
    private final ParticipationStatus status;
    private final Instant enrolledAt;

    private CourseParticipation(ParticipationId id, UserId userId, CourseRunId courseRunId,
                                ParticipationStatus status, Instant enrolledAt) {
        this.id = Objects.requireNonNull(id);
        this.userId = Objects.requireNonNull(userId);
        this.courseRunId = Objects.requireNonNull(courseRunId);
        this.status = Objects.requireNonNull(status);
        this.enrolledAt = Objects.requireNonNull(enrolledAt);
    }

    public static CourseParticipation enroll(UserId userId, CourseRunId courseRunId, Instant now) {
        return new CourseParticipation(ParticipationId.NEW, userId, courseRunId,
                                       ParticipationStatus.ACTIVE, now);
    }

    public CourseParticipation cancel() {
        if (status == ParticipationStatus.COMPLETED) {
            throw new IllegalStateException(
                "Нельзя отменить запись на пройденный курс: " + id.value());
        }
        return new CourseParticipation(id, userId, courseRunId,
                                       ParticipationStatus.CANCELLED, enrolledAt);
    }

    public boolean isActive() {
        return status == ParticipationStatus.ACTIVE;
    }

    // Второй способ получить объект: собрать запись, которая уже лежит
    // в базе. Вызывает его код инфраструктуры, прочитав строку таблицы.
    public static CourseParticipation restore(ParticipationId id, UserId userId,
                                              CourseRunId courseRunId,
                                              ParticipationStatus status, Instant enrolledAt) {
        return new CourseParticipation(id, userId, courseRunId, status, enrolledAt);
    }

    // Опущены: метод complete() и чтение полей - id(), userId(),
    // courseRunId(), status(), enrolledAt().
}
Посмотрим, чем он отличается от сущности с тем же именем из привычного варианта.
Правило находится внутри. Состояние записи меняется не сеттером, а методом cancel, и в этом методе проверяется запрет: запись на пройденный курс отменить нельзя. Другого способа получить отменённую запись у сценариев нет, поэтому обойти запрет не выйдет, сколько бы путей отмены ни появилось в системе. Метод restore, о котором речь пойдёт ниже, собирает объект в любом состоянии, но он предназначен не для сценариев. Это ответ на четвёртое следствие привычного варианта, где правило жило в сервисе. Заметим: ответ дал не интерфейс к хранилищу, а то, что у объекта появились собственные методы.
Объект не меняется после создания. Все поля объявлены final, сеттеров нет. Метод cancel не трогает текущий объект, а возвращает новый - с другим состоянием. Такие объекты называют неизменяемыми. Их можно передавать в любой код, не опасаясь, что где-то по дороге у них поменяется поле.
Наполовину заполненный объект создать нельзя. Конструктор закрыт (private), а каждый его параметр проверяется вызовом Objects.requireNonNull: если хоть одно значение не передано, объект не будет создан. С сущностью так не получится: JPA требует конструктор без параметров и поля без final.
Снаружи объект создаётся только двумя статическими методами, и нужны оба.
enroll создаёт новую запись - ту, которой ещё нет в базе. Метод сам назначает ей начальное состояние «активная» и помечает, что идентификатора у неё пока нет (ParticipationId.NEW): идентификатор назначит база при сохранении. Снаружи приходят только пользователь, запуск курса и текущее время.
restore (от английского «восстановить») собирает объект по записи, которая уже лежит в базе. Здесь назначать нечего: у записи есть идентификатор, состояние и дата, и метод возвращает объект ровно в том виде, в каком он хранится. Вызывает restore код инфраструктуры, когда прочитал строку из таблицы и превращает её в доменный объект. Метод открытый, иначе код из другого модуля не смог бы его вызвать. Значит, технически его может вызвать и сценарий. Удерживает от этого договорённость в команде, а при желании - тест границы из раздела «Уровни строгости»: ArchUnit умеет запрещать и вызовы отдельных методов.
Почему методов два, а не один открытый конструктор на пять параметров? Потому что новая запись и прочитанная из базы - разные случаи. Новой записи состояние и пустой идентификатор назначают правила. Прочитанной ничего назначать нельзя: её надо воспроизвести как есть. Будь вход один, сценарий создавал бы новую запись тем же конструктором, что и инфраструктура, и сам передавал бы ей состояние и идентификатор, а значит, мог бы в них ошибиться. С двумя методами сценарию хватает enroll: начальное состояние и пустой идентификатор метод назначит сам.
Остальные классы примера
В коде доменного объекта встретились типы, которые ещё не показаны. Вот они, а заодно и остальные классы, о которых пойдёт речь дальше:
// courses-domain
public record UserId(Long value) { }
public record CourseRunId(Long value) { }

public record ParticipationId(Long value) {
    public static final ParticipationId NEW = new ParticipationId(null);
    public boolean isNew()  { return value == null; }
    public Long required()  { return Objects.requireNonNull(value); }
}

public enum ParticipationStatus { ACTIVE, CANCELLED, COMPLETED }

// courses-application
public class TooManyActiveCoursesException extends RuntimeException { /* ... */ }

// courses-persistence - те же классы с @Entity, что в начале статьи,
// только переименованные, чтобы не путать с доменными:
@Entity class CourseParticipationEntity { /* ... */ }
@Entity class UserEntity                { /* ... */ }
@Entity class CourseRunEntity           { /* ... */ }
@Entity class ProgramEntity             { /* ... */ }
record - короткая запись неизменяемого класса в Java: конструктор, методы чтения полей и сравнение по значению компилятор создаёт сам. UserId, CourseRunId и ParticipationId - обёртки вокруг числового идентификатора.
Зачем обёртки, если внутри всё тот же Long? Чтобы компилятор различал, чей это идентификатор. Метод findActiveForUser(UserId) не примет идентификатор запуска курса, хотя оба - просто числа. С голым Long такую путаницу поймал бы только тест, и то если бы его написали.
У ParticipationId есть особенность: у новой записи идентификатора ещё нет. Домен говорит об этом прямо. Константа NEW означает «пока не назначен», метод isNew() проверяет, назначен ли он, а required() возвращает число и падает, если числа нет; он нужен там, где идентификатор обязан быть. По isNew() код инфраструктуры потом решит, вставлять новую строку в таблицу или обновлять существующую.
TooManyActiveCoursesException - исключение, которое сценарий бросает при попытке записаться на четвёртый курс.
Сущности в инфраструктуре - те же классы с @Entity, что в привычном варианте, только с приставкой Entity в имени, чтобы не путать их с доменными. Их поля и связи разобраны в начале статьи; что в них добавилось, будет сказано там, где они понадобятся.
Порт
Теперь интерфейс, через который правила обращаются к хранилищу. Такой интерфейс называют портом: код правил объявляет его для себя сам и перечисляет в нём операции, которые ему нужны от внешнего мира.
Слово пришло из вычислительной техники. У компьютера есть разъём USB. Флешка, клавиатура, принтер подключаются к нему, и компьютеру не нужно знать, как каждое устройство устроено внутри: достаточно, чтобы оно подходило к разъёму. Форму разъёма задаёт компьютер, а не производитель флешки. Аналогия грубая, но направление мысли передаёт: интерфейс задаёт код правил, а хранилище к нему подключается.
package com.example.courses.domain;

public interface CourseParticipations {

    List<CourseParticipation> findActiveForUser(UserId userId);

    Optional<CourseParticipation> findById(ParticipationId id);

    CourseParticipation save(CourseParticipation participation);
}
Три метода: прочитать активные записи пользователя, прочитать одну запись по идентификатору и сохранить запись. Это всё, что нужно сценариям записи на курс и отмены записи.
От обычного репозитория порт отличается не столько тем, что в нём есть, сколько тем, чего в нём нет.
Нет наследования от JpaRepository. Иначе домен зависел бы от Spring Data и вместе с наследством получил бы обратно все три десятка операций.
Нет типов Spring Data в объявлениях методов. Ни Page, ни Pageable, ни Sort. Стоит одному из них попасть в объявление - и доменный модуль перестанет собираться без Spring Data. Если правилам понадобится выдача по страницам, домен объявит для неё свои параметры, например номер страницы и её размер обычными числами.
Нет сущностей. CourseParticipation в объявлениях - доменный объект из этого же модуля, а не класс с @Entity.
Нет запросов. Ни @Query, ни join fetch. Метод называется findActiveForUser и обещает активные записи пользователя. Как их достать (одним запросом или двумя, что подтянуть сразу, по какой колонке искать), решает инфраструктура.
Последний пункт важнее, чем выглядит. В привычном варианте один метод findAllForUser с одним запросом обслуживает и правило про три курса, и экран «мои курсы». Допустим, кто-то решил показывать на экране только последние десять записей и ограничил ими запрос. Правило начнёт считать активные записи по неполному списку, хотя его код никто не трогал. Когда порт объявляет отдельный метод «активные записи пользователя», а запросы для экранов живут отдельно, такая правка правило не заденет. Переписать запрос порта тоже можно, не открыв ни одного файла домена: он лежит в инфраструктуре.
И про имя. Интерфейс назван CourseParticipations («записи на курсы»), а не CourseParticipationRepository. Слово «репозиторий» в проектах на Spring закрепилось за интерфейсами Spring Data, а порт - часть домена, и имя из понятий предметной области помогает не путать два интерфейса ни в коде, ни в разговоре. Это соглашение, а не требование.
Сценарий
package com.example.courses.application;

@Service
public class EnrollUser {

    private static final int MAX_ACTIVE_COURSES = 3;

    private final CourseParticipations participations;
    private final Clock clock;

    public EnrollUser(CourseParticipations participations, Clock clock) {
        this.participations = participations;
        this.clock = clock;
    }

    @Transactional
    public CourseParticipation enroll(UserId userId, CourseRunId courseRunId) {
        List<CourseParticipation> active = participations.findActiveForUser(userId);

        if (active.size() >= MAX_ACTIVE_COURSES) {
            throw new TooManyActiveCoursesException(
                "У пользователя " + userId.value() + " уже " + active.size()
                + " активных курсов, допускается " + MAX_ACTIVE_COURSES);
        }

        CourseParticipation participation =
            CourseParticipation.enroll(userId, courseRunId, clock.instant());

        return participations.save(participation);
    }
}
Сценарий EnrollUser делает то же, что метод enroll привычного сервиса. Сравним их конструкторы. Привычный сервис получал три репозитория Spring Data. EnrollUser получает порт CourseParticipations и часы. Он не знает, что за портом стоит база PostgreSQL, что обращения идут через Spring Data и что активные записи достаются одним запросом.
Аннотации @Service и @Transactional на сценарии остались. Сценарии знают про Spring: Spring создаёт их при запуске и управляет транзакциями. Не знают они другого: Spring Data и сущностей.
Часы (объект Clock из стандартной библиотеки Java) попали в конструктор по той же причине, что и хранилище. Вызов Instant.now() внутри метода берёт время у операционной системы, и подменить его в тесте нельзя: проверить, что запись создаётся с моментом «1 марта, 10:00», не получится. Через конструктор тест передаёт часы, остановленные на нужном моменте. Во второй части серии тот же приём показан на одной функции, и итог там подведён так: «Время и база данных превратились из скрытых зависимостей в явные параметры». Здесь он применён к сценарию целиком.
Отбора активных записей в сценарии больше нет: он просит у порта сразу активные. Отбор переехал в запрос к базе, и проверять его будет тест запроса, как обсуждалось в разделе про моки.
Заметим, где теперь живёт правило про лимит: в сценарии, а не в доменном объекте. Оно касается не одной записи, а всех активных записей пользователя сразу, и для проверки ему нужно хранилище. Запрет отменять пройденный курс, наоборот, касается одной записи и поэтому живёт в её методе cancel.
Ещё две мелочи, к инверсии отношения не имеющие. Число 3 вынесено в константу MAX_ACTIVE_COURSES, а вместо IllegalStateException сценарий бросает собственное исключение с сообщением, по которому видно, сколько курсов у пользователя и сколько допускается. Правило от этого проще найти и проще понять по сообщению об ошибке.
Адаптер и маппер
Порт объявлен - кто-то должен его реализовать. Класс, который реализует порт со стороны хранения, называют адаптером. Он переводит просьбы домена в вызовы конкретной технологии (здесь это JPA и Spring Data). В аналогии с разъёмом это переходник: с одной стороны у него разъём, которого ждёт компьютер, с другой - разъём прибора со своим устройством. Прибор здесь - JPA и Spring Data, а переходник подгоняет их под порт.
Работает адаптер с сущностью CourseParticipationEntity. Это тот же класс с @Entity, что CourseParticipation в привычном варианте, только переименованный: те же поля, связи с пользователем и запуском курса, конструктор без параметров для JPA. Добавился конструктор со всеми полями: им пользуется код инфраструктуры, когда создаёт новую сущность.
В коде адаптера встретятся ещё две вещи из фреймворков. Аннотация @Repository сообщает Spring, что объект этого класса нужно создать при запуске и передавать всем, кому нужен CourseParticipations. EntityManager - главный объект JPA: через него сущности читаются из базы, сохраняются и связываются друг с другом.
package com.example.courses.persistence;

@Repository
class JpaCourseParticipations implements CourseParticipations {

    private final CourseParticipationJpaRepository jpa;
    private final EntityManager entityManager;

    JpaCourseParticipations(CourseParticipationJpaRepository jpa,
                            EntityManager entityManager) {
        this.jpa = jpa;
        this.entityManager = entityManager;
    }

    @Override
    public List<CourseParticipation> findActiveForUser(UserId userId) {
        return jpa.findActiveForUser(userId.value()).stream()
            .map(CourseParticipationMapper::toDomain)
            .toList();
    }

    @Override
    public Optional<CourseParticipation> findById(ParticipationId id) {
        return jpa.findById(id.required())
            .map(CourseParticipationMapper::toDomain);
    }

    @Override
    public CourseParticipation save(CourseParticipation participation) {
        if (participation.id().isNew()) {
            UserEntity user = entityManager.getReference(
                UserEntity.class, participation.userId().value());
            CourseRunEntity courseRun = entityManager.getReference(
                CourseRunEntity.class, participation.courseRunId().value());

            CourseParticipationEntity saved = jpa.save(
                CourseParticipationMapper.toNewEntity(participation, user, courseRun));

            return CourseParticipationMapper.toDomain(saved);
        }

        CourseParticipationEntity managed = jpa.findById(participation.id().required())
            .orElseThrow(() -> new NoSuchElementException(
                "Запись исчезла между чтением и сохранением"));

        managed.setStatus(participation.status());

        return CourseParticipationMapper.toDomain(managed);
    }
}
Внутри адаптер пользуется знакомым интерфейсом Spring Data, который переехал в инфраструктуру:
package com.example.courses.persistence;

interface CourseParticipationJpaRepository
        extends JpaRepository<CourseParticipationEntity, Long> {

    @Query("select p from CourseParticipationEntity p "
         + " join fetch p.courseRun "
         + " where p.user.id = :userId "
         + "   and p.status = com.example.courses.domain.ParticipationStatus.ACTIVE")
    List<CourseParticipationEntity> findActiveForUser(@Param("userId") Long userId);
}
Spring Data по-прежнему даёт этому интерфейсу около трёх десятков готовых операций. Изменилось то, кто их видит: интерфейс подключён только к адаптеру, сценарии его не получают.
Запрос изменился в двух местах. Отбор активных записей переехал в него из сервиса (условие p.status = ...ACTIVE). А join fetch r.program исчез: название программы правилам не нужно, его показывает только экран «мои курсы», и для экрана будет свой запрос; он описан в разделе «Что не нужно инвертировать». Обе правки следуют из порта: запрос подстраивается под то, о чём просит домен.
Адаптер и интерфейс Spring Data объявлены без слова public, то есть видны только внутри своего пакета com.example.courses.persistence. Код из других пакетов не может даже упомянуть их имена ни в типе переменной, ни в строке импорта. Видимость в Java ограничена пакетом, а не модулем сборки, но этот пакет целиком лежит в модуле инфраструктуры, так что снаружи модуля до них не добраться. Spring это не мешает: он создаёт объекты при запуске приложения в обход обычных правил видимости.
Здесь и происходит инверсия, о которой шла речь во введении. Модуль courses-persistence ссылается на courses-domain: импортирует порт и доменный объект. Обратной ссылки нет, и добавить её не получится: Maven откажется собирать модули, которые ссылаются друг на друга по кругу. А вызов идёт, как и раньше, от сценария к базе.
Метод save стоит пояснить. Если запись новая (id().isNew()), адаптер создаёт сущность и сохраняет её: jpa.save вставит строку в таблицу, а база назначит идентификатор. Для связей сущности нужны пользователь и запуск курса, но читать их из базы незачем: entityManager.getReference даёт ссылку по идентификатору без запроса, так же как getReferenceById в привычном варианте.
Если запись уже есть в базе, адаптер читает её сущность и переносит в неё новое состояние. Остальные поля переносить незачем: у доменного объекта после создания меняется только состояние. Вызова jpa.save в этой ветке нет намеренно. Сущность, прочитанная внутри транзакции, считается управляемой: JPA следит за её полями и сама запишет изменения в базу, когда транзакция завершится. А транзакцию открывает сценарий: на нём стоит @Transactional. Отсюда ограничение: вызванный вне транзакции, этот метод изменение потеряет. Это ещё один довод за то, чтобы транзакции начинались и заканчивались в сценариях.
Остаётся класс, который превращает сущность в доменный объект и обратно. Его называют маппером (от английского map - «сопоставлять»): он берёт значения полей одного объекта и переносит их в поля другого.
package com.example.courses.persistence;

final class CourseParticipationMapper {

    private CourseParticipationMapper() { }

    static CourseParticipation toDomain(CourseParticipationEntity entity) {
        return CourseParticipation.restore(
            new ParticipationId(entity.getId()),
            new UserId(entity.getUser().getId()),
            new CourseRunId(entity.getCourseRun().getId()),
            entity.getStatus(),
            entity.getEnrolledAt());
    }

    static CourseParticipationEntity toNewEntity(CourseParticipation participation,
                                                 UserEntity user,
                                                 CourseRunEntity courseRun) {
        return new CourseParticipationEntity(
            null,
            user,
            courseRun,
            participation.status(),
            participation.enrolledAt());
    }
}
toDomain вызывается, когда строку прочитали из базы: из сущности берутся её идентификатор, идентификаторы связанных пользователя и запуска курса, состояние и дата записи, и методом restore из них собирается доменный объект. toNewEntity работает в обратную сторону и только для новой записи: идентификатор передаётся пустым (null), его назначит база.
Маппер пишется руками и правится каждый раз, когда у записи появляется новое поле. Во что это обходится, разобрано в разделе «Что этот вариант даёт и чем платит».
У маппера есть свойство, которое видно не сразу. Он вызывается внутри транзакции, пока соединение с базой открыто, и всё, что нужно доменному объекту, читает из сущности тут же. Наружу уходит объект, которому база больше не понадобится. В привычном варианте наружу уходила сама сущность, и если код уже после завершения транзакции обращался к её ленивой связи, он получал исключение LazyInitializationException: соединения нет, дочитать связанный объект нечем. Здесь такой ошибке взяться неоткуда.
Тест, которому не нужна база
Порт - обычный интерфейс, и вторая его реализация для тестов пишется за несколько минут. Записи она держит в обычном списке:
class InMemoryCourseParticipations implements CourseParticipations {

    private final List<CourseParticipation> storage = new ArrayList<>();
    private final AtomicLong sequence = new AtomicLong(0);

    @Override
    public List<CourseParticipation> findActiveForUser(UserId userId) {
        return storage.stream()
            .filter(p -> p.userId().equals(userId))
            .filter(CourseParticipation::isActive)
            .toList();
    }

    @Override
    public Optional<CourseParticipation> findById(ParticipationId id) {
        return storage.stream()
            .filter(p -> !p.id().isNew() && p.id().equals(id))
            .findFirst();
    }

    @Override
    public CourseParticipation save(CourseParticipation participation) {
        ParticipationId id = participation.id().isNew()
            ? new ParticipationId(sequence.incrementAndGet())
            : participation.id();

        CourseParticipation stored = CourseParticipation.restore(
            id, participation.userId(), participation.courseRunId(),
            participation.status(), participation.enrolledAt());

        storage.removeIf(p -> !p.id().isNew() && p.id().equals(id));
        storage.add(stored);
        return stored;
    }
}
Отбор активных записей (фильтр isActive) записан здесь один раз для всех тестов. Его можно прочитать, в нём можно поставить точку останова и пройти отладчиком. Это тоже заглушка, но не мок: обычный класс, а не набор ответов, который задаётся заново в каждом тесте.
Фильтр isActive - тоже предположение о том, что вернёт настоящий запрос. Разница в том, что предположение теперь одно на весь проект и его можно проверить. Для этого обе реализации порта (в памяти и адаптер) прогоняют через один и тот же набор проверок: сохранили активную и отменённую записи, вызвали findActiveForUser - вернулась одна. Для реализации в памяти такая проверка идёт за миллисекунды, для адаптера - на настоящей базе. Если обе проходят, реализация в памяти ведёт себя так же, как настоящее хранилище, и тесты правил, построенные на ней, ничего не выдумывают.
С ней проверка правила выглядит так:
class EnrollUserTest {

    private static final Clock FIXED_CLOCK =
        Clock.fixed(Instant.parse("2026-03-01T10:00:00Z"), ZoneOffset.UTC);

    private final InMemoryCourseParticipations participations =
        new InMemoryCourseParticipations();

    private final EnrollUser enrollUser = new EnrollUser(participations, FIXED_CLOCK);

    @Test
    void не_даёт_записаться_на_четвёртый_курс() {
        UserId user = new UserId(1L);
        enrollUser.enroll(user, new CourseRunId(100L));
        enrollUser.enroll(user, new CourseRunId(200L));
        enrollUser.enroll(user, new CourseRunId(300L));

        assertThrows(TooManyActiveCoursesException.class,
            () -> enrollUser.enroll(user, new CourseRunId(400L)));
    }

    @Test
    void отменённая_запись_освобождает_место() {
        UserId user = new UserId(1L);
        CourseParticipation first = enrollUser.enroll(user, new CourseRunId(100L));
        enrollUser.enroll(user, new CourseRunId(200L));
        enrollUser.enroll(user, new CourseRunId(300L));

        participations.save(first.cancel());

        assertTrue(enrollUser.enroll(user, new CourseRunId(400L)).isActive());
    }
}
Сценарий собирается обычным new: ему передают хранилище в памяти и часы, остановленные на 1 марта 2026 года, 10:00. Это возможно потому, что сценарий зависит от интерфейса, а не от Spring Data. В файле теста нет ни @SpringBootTest, ни @DataJpaTest, ни базы, ни моков, и выполняется он за миллисекунды. Второй тест проверяет как раз то, мимо чего прошёл мок в привычном варианте: отменённая запись освобождает место.
Специально для теста ничего не понадобилось: ни настройки Spring, ни библиотеки моков. Хватило того, что сценарий зависит от интерфейса, а время получает через конструктор. Во второй части серии эта связь сформулирована так: «если что-то трудно протестировать, проблема почти никогда не в тестах. Проблема в структуре». Здесь видно то же самое с обратной стороны: поправили структуру - и тест стал простым сам.
Тест на настоящей базе после этого тоже нужен, но проверяет он уже не правило, а хранение: правильно ли запрос отбирает активные записи, совпадают ли сущности со схемой таблиц, верно ли маппер переносит поля, назначает ли база идентификаторы. Получается такая пропорция: быстрых тестов правил много, и они перебирают все случаи; медленных тестов хранения немного, и они проверяют, что данные действительно доходят до базы и возвращаются обратно.
Что этот вариант даёт и чем платит
Вернёмся к четырём следствиям привычного варианта и посмотрим, что стало с каждым.
Сценарий не зависит от разметки таблицы. EnrollUser работает с доменным объектом, а @Entity остался в инфраструктуре. Если пользователя в таблице решат хранить не связью, а числом, поменяются сущность и маппер, а файл с правилом про три курса останется прежним.
Лишних операций нет. Сценарию доступны три метода порта. deleteAllInBatch из него не вызвать: в порту такого объявления нет.
Правило проверяется без мока. Тесты сценариев работают с одной реализацией порта в памяти, а вопрос «правильно ли отбираются активные записи» проверяется отдельно, тестом запроса на настоящей базе.
Правило переехало в доменный объект. Запрет отменять пройденный курс проверяется в методе cancel, и ни один сценарий отмены его не обойдёт.
Теперь о том, чем за это платят.
Два класса на одну запись. CourseParticipation и CourseParticipationEntity описывают одно и то же, и новое поле придётся добавлять в оба.
Маппер. На пяти полях он короткий. Но объекты бывают сложнее: со списками вложенных объектов, с полями-объектами, с датами в разных часовых поясах. Тогда маппер - заметный объём кода, который надо написать, покрыть тестами и править вместе с каждым полем. Есть библиотеки, которые создают такой код автоматически по описанию, например MapStruct, но поначалу проще написать его руками: так видно, что куда переносится.
Больше файлов. В привычном варианте у записи на курс два файла: интерфейс репозитория и сущность. Здесь их шесть: доменный объект, порт, интерфейс Spring Data, адаптер, маппер и сущность. Дорога по коду тоже становится длиннее: щёлкнув в среде разработки по вызову participations.save(...) в сценарии, читатель попадает в объявление порта, а не в работающий код, и реализацию ищет отдельно.
Если вдобавок разносить код по модулям сборки, растёт и время сборки, но это отдельный выбор, общий для обоих вариантов с портом; он разобран в разделе «Уровни строгости».
Нужно ли всё это проекту? В третьей части серии предложен ориентир: инвертировать зависимость стоит там, где можно внятно назвать второй возможный вариант реализации. У хранилища он есть почти всегда: хотя бы реализация в памяти, которую мы только что написали для теста. Но ориентир отвечает на вопрос, нужен ли порт, а не на вопрос, нужна ли отдельная модель. Порт - это один файл. Отдельная модель - второй класс и маппер на каждый объект предметной области. Бывает, что порт уже нужен, а отдельная модель пока нет. Для этого случая и существует переходный вариант.
Переходный вариант: порт без отдельной модели
Идея такая: сущность остаётся единственным классом записи на курс, а интерфейс Spring Data, вместо того чтобы внедряться в сервис, реализует порт. Порт объявлен в доменном модуле, как и в предыдущем варианте:
// courses-domain
public interface CourseParticipations {

    CourseParticipation save(CourseParticipation participation);

    Optional<CourseParticipation> findById(Long id);

    List<CourseParticipation> findActiveForUser(Long userId);
}
А интерфейс Spring Data в инфраструктуре наследует сразу и порт, и JpaRepository:
// courses-persistence
interface CourseParticipationJpaRepository
        extends CourseParticipations, JpaRepository<CourseParticipation, Long> {

    @Override
    @Query("select p from CourseParticipation p "
         + " join fetch p.courseRun "
         + " where p.user.id = :userId "
         + "   and p.status = com.example.courses.domain.ParticipationStatus.ACTIVE")
    List<CourseParticipation> findActiveForUser(@Param("userId") Long userId);
}
Реализацию этого интерфейса Spring Data создаёт так же, как раньше, и она годится для порта целиком. Методы save и findById порта совместимы с теми, что JpaRepository наследует от CrudRepository, и выполняются готовым кодом Spring Data; что значит «совместимы», разобрано ниже, в подразделе о ловушке. Метод findActiveForUser выполняется запросом из @Query. Порт реализован, а класс-адаптер писать не пришлось.
Модули те же, что в варианте с отдельной моделью, но разложено по ним другое:
модуль                что внутри                                  от каких модулей зависит
courses-domain        сущности с @Entity, порты                   ни от каких
courses-application   ParticipationService, транзакции            courses-domain
courses-persistence   интерфейсы Spring Data, наследующие порты   courses-domain
courses-app           запуск приложения, веб-слой                 от всех трёх
Отличие от варианта с отдельной моделью - в первой строке. В домене лежат порты и сущности (CourseParticipation, User, CourseRun, Program) вместе с их аннотациями, поэтому из внешних библиотек домену нужна JPA (jakarta.persistence-api). Направление зависимостей между модулями при этом то же: все стрелки ведут к домену, и сервис с правилами, как и прежде, не зависит от инфраструктуры. Отдельного доменного объекта нет, правила работают с сущностью, поэтому и маппер не нужен: копировать значения полей между двумя классами не приходится, класс один. Запрос тот же, что в адаптере варианта с отдельной моделью: отбор активных записей в нём есть, а программа не подтягивается, потому что правилу она не нужна.
Так же поступают с двумя другими репозиториями сервиса. Пользователь и запуск курса нужны сервису только ради ссылки по идентификатору, поэтому их порты состоят из одного метода:
// courses-domain
public interface Users {
    User getReferenceById(Long id);
}

public interface CourseRuns {
    CourseRun getReferenceById(Long id);
}

// courses-persistence
interface UserJpaRepository extends Users, JpaRepository<User, Long> { }

interface CourseRunJpaRepository extends CourseRuns, JpaRepository<CourseRun, Long> { }
Сервис после этого выглядит так:
@Service
public class ParticipationService {

    private final CourseParticipations participations;
    private final CourseRuns courseRuns;
    private final Users users;

    public ParticipationService(CourseParticipations participations,
                                CourseRuns courseRuns,
                                Users users) {
        this.participations = participations;
        this.courseRuns = courseRuns;
        this.users = users;
    }

    @Transactional
    public CourseParticipation enroll(Long userId, Long courseRunId) {
        List<CourseParticipation> active = participations.findActiveForUser(userId);

        if (active.size() >= 3) {
            throw new IllegalStateException("Слишком много активных курсов");
        }

        CourseParticipation participation = new CourseParticipation();
        participation.setUser(users.getReferenceById(userId));
        participation.setCourseRun(courseRuns.getReferenceById(courseRunId));
        participation.setStatus(ParticipationStatus.ACTIVE);
        participation.setEnrolledAt(Instant.now());

        return participations.save(participation);
    }
}
По сравнению с привычным вариантом поменялись типы в конструкторе и исчез фильтр: активные записи теперь отбирает запрос. Остальное не тронуто. В сервисе не осталось ни одного типа Spring Data.
Что этот вариант даёт. Сервис больше не видит JpaRepository и его операций: ему доступны три метода одного порта и по одному методу двух других. @Query переехала в инфраструктуру. Для тестов можно написать свою реализацию порта в памяти, как в предыдущем варианте, с той разницей, что хранить она будет сущности.
Чего он не даёт. На классе CourseParticipation по-прежнему стоит @Entity, а сам класс теперь лежит в доменном модуле. Значит, в pom.xml этого модуля придётся добавить библиотеку jakarta.persistence-api, иначе аннотации JPA не скомпилируются. Домен без единой внешней зависимости здесь не получится: он знает разметку таблицы. И запрет отменять пройденный курс по-прежнему живёт в сервисе. Перенести его в сущность можно: добавить ей метод cancel с проверкой и убрать сеттер setStatus. Но тогда класс, описывающий таблицу, начинает описывать и поведение записи, и правка одного задевает другое. Это уже первый шаг к отдельной модели.
Ловушка с объявлениями методов
Приём работает не с любым портом. Если в порту есть метод с тем же именем, что у метода CrudRepository (а save и findById там есть), объявления должны быть совместимы: те же типы параметров и подходящий тип результата. Иначе интерфейс Spring Data не скомпилируется. Например, привычное для порта объявление void save(CourseParticipation participation) даёт такую ошибку:
error: types CrudRepository<CourseParticipation,Long> and CourseParticipations
       are incompatible;
  both define save(CourseParticipation), but with unrelated return types
Причина в том, как save объявлен в Spring Data: <S extends T> S save(S entity). В JpaRepository<CourseParticipation, Long> вместо T стоит CourseParticipation, то есть метод принимает запись (или объект её подкласса) и возвращает объект того же типа. Сверяя интерфейсы, компилятор считает save из порта и save из Spring Data одним методом: параметр у них один и тот же. А у одного метода не может быть двух несовместимых типов результата: void и CourseParticipation. Ошибка видна сразу, при компиляции, а не при запуске приложения.
Отсюда два ограничения. Сохранение в порту объявляется как CourseParticipation save(CourseParticipation), а не void. А findById должен принимать Long: тип идентификатора у CrudRepository задан вторым параметром в JpaRepository<CourseParticipation, Long>, и обёртку ParticipationId в этот метод не подставить.
Выходит, что в переходном варианте объявления порта подогнаны под интерфейс Spring Data, а не под нужды правил. Как промежуточная ступень это работает. Как конечная точка для проекта, где правил много, - хуже: каждое новое объявление в порту приходится сверять с CrudRepository.
Практический ориентир: сверьтесь с четырьмя следствиями привычного варианта. Переходный вариант убирает два из них (лишние операции и проверку правила через мок) и попутно уносит @Query в инфраструктуру. Два остаются: домен знает разметку таблицы, а запрет отменять пройденный курс живёт в сервисе. Если эти два вам сейчас не мешают, на переходном варианте можно остановиться.
Три варианта рядом
Сведём различия в одно место.
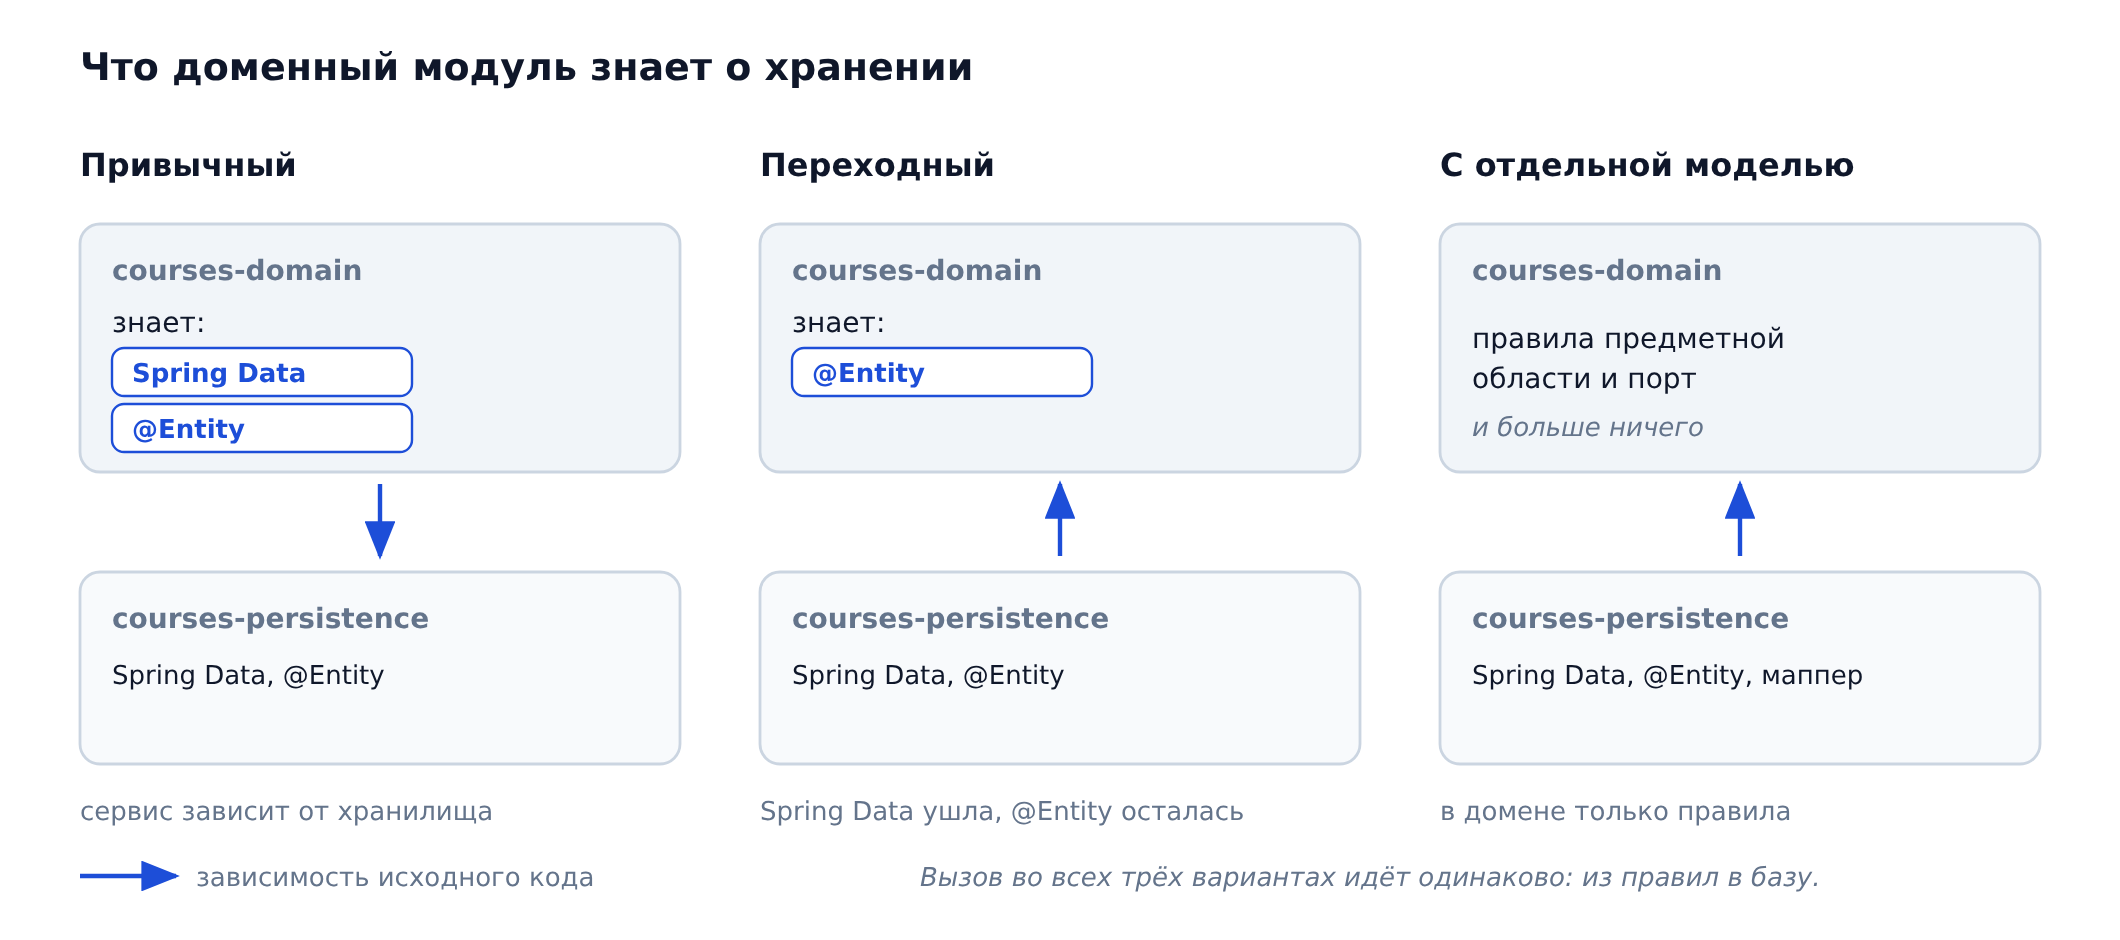
Рисунок 1. Что код правил знает о хранении; на рисунке он подписан именем доменного модуля courses-domain. В привычном варианте - и Spring Data, и разметку таблицы. В переходном Spring Data уходит, а @Entity остаётся. В варианте с отдельной моделью уходит и @Entity, зато появляется маппер. Вызов во всех трёх вариантах идёт одинаково: из правил в базу.
| |
Привычный |
Переходный |
С отдельной моделью |
| Код правил знает про Spring Data |
да |
нет |
нет |
| Код правил знает разметку таблицы |
да |
да |
нет |
| Операций хранилища доступно коду записи на курс |
около тридцати в каждом из трёх репозиториев |
пять в трёх портах |
три в одном порту |
Где лежит @Query |
в интерфейсе, который видит сервис |
в инфраструктуре |
в инфраструктуре |
| Чем заменяют хранилище в тесте правила |
мок |
своя реализация порта |
своя реализация порта |
| Где записан запрет отменять пройденный курс |
в сервисе |
в сервисе |
в доменном объекте |
| Файлов на объект «запись на курс» |
два |
три |
шесть |
| Маппер |
нет |
нет |
есть |
Последние две строки - то, чем платят: сколько кода придётся написать и потом поддерживать. Первые шесть - то, что за это получают.
Зачем уходить от привычного варианта
Таблица показывает различия, но не отвечает на вопрос, который задаст тот, у кого код уже работает: что изменится в ежедневной работе после переделки? Изменятся четыре вещи, и все они касаются того, что разработчик делает с правилами каждый день: читает их, меняет и проверяет. Третья из них появляется уже в переходном варианте, остальные - только при отдельной модели.
Правило можно прочитать, не зная схемы базы. Новый человек открывает EnrollUser и видит: если активных записей три или больше - отказать. Ни таблиц, ни колонок, ни join fetch. Чтобы понять правило, его достаточно прочитать, а чтобы поменять, не нужно разбираться, как устроено хранение.
Изменение схемы не доходит до правил. Переименовали колонку, разбили таблицу на две, заменили связь числом - правятся сущность и маппер. Файл с правилом при этом не меняется, и перепроверять его перед выпуском новой версии незачем.
Тесты правил быстрые и не опираются на догадки. Они не поднимают базу и не содержат предположений о том, что вернёт запрос: проверка запроса вынесена в отдельный тест на настоящей базе.
Каждое правило записано в одном месте. Запрет отменять пройденный курс живёт в методе cancel. Сколько бы путей отмены ни появилось, проверка у них общая, и забыть её в новом пути не получится: другого способа отменить запись у сценариев нет.
Полная переделка (до отдельной модели) стоит своих шести файлов на объект тогда, когда правил в системе становится столько, что их чтение, изменение и проверка занимают заметную часть работы команды. Если правил почти нет и код в основном переносит данные из формы в таблицу и обратно, эти четыре изменения ничего не облегчают: читать, менять и проверять почти нечего.
Как выбрать вариант для нового проекта
Размер проекта и число разработчиков здесь подсказывают мало. Важнее, какого кода в проекте будет больше, а код бывает двух видов.
Код, который переносит данные. Пришёл запрос - прочитали строки из таблицы - показали на экране. Или наоборот: пришла заполненная форма - разложили значения по колонкам - сохранили. Между «пришло» и «сохранили» такой код ничего не решает: не сравнивает, не проверяет условий, не отказывает. Экран «мои курсы» из нашего примера - как раз такой код.
Код, который принимает решения. Прежде чем что-то сделать, он проверяет условия и может отказать или выбрать один из путей. Запись на курс - такой код: прежде чем вставить строку, надо посчитать активные записи пользователя и при трёх отказать. Условие задано не программистом и не базой: его установили те, кто отвечает за продукт.
Прикиньте, какого кода в вашем проекте будет больше. От этого и зависит выбор.
Привычный вариант - когда решений почти нет. Справочник городов, панель администратора для правки записей, внутренний отчёт, прототип, который выбросят через месяц. Порт и отдельная модель отделяют правила от хранения, а правил здесь нет. Каждый объект обошёлся бы в четыре лишних файла (порт, адаптер, доменный класс и маппер), и ни один из них не упростил бы ни чтение, ни изменение, ни проверку кода, который просто переносит поля.
Переходный вариант - когда правила есть, но их немного. Например, интернет-магазин небольшой компании. Правил там несколько: нельзя заказать товар, которого нет на складе; скидка положена при сумме заказа от пяти тысяч; отменить можно только неоплаченный заказ. Всё остальное (каталог, корзина, личный кабинет) переносит данные. Переходный вариант стоит нескольких коротких интерфейсов (по одному на каждый репозиторий, которым пользуется код правил) и сразу убирает Spring Data из этого кода. Если отдельная модель так и не понадобится, лишнего написано немного: несколько коротких интерфейсов.
Вариант с отдельной моделью - когда правил много или видно, что их станет много. Вот четыре признака, которые встречаются чаще других: при любом из них его стоит выбрать сразу, не проходя через переходный.
Правила меняются чаще, чем схема базы. Банковские тарифы, расчёт страховки, условия акций в магазине: их правят каждый месяц, а таблицы остаются прежними. Если код таких правил работает с классами, размеченными под таблицы, правки правил и правки хранения то и дело попадают в одни и те же файлы, и каждую приходится проверять с оглядкой на другую.
Схему базы задаёт кто-то другой. База досталась от старой системы, в неё пишут другие приложения, и менять в ней ничего нельзя. Колонки называются как-нибудь вроде F_USR_ID; половина из них не используется. Если правила работают прямо с сущностями такой таблицы, в их коде появятся F_USR_ID и непонятные числовые коды. С отдельной моделью у доменных классов понятные имена и те типы, которые нужны правилам, а перевод из чужой схемы собран в маппере.
Одно правило нужно соблюдать во многих местах. Например, в магазине заказ отменяет покупатель, оператор, склад при нехватке товара и сама система, если заказ не оплачен вовремя. И везде действует одно правило: оплаченный заказ отменить нельзя. Если правило живёт в сервисе, а у сущности открыт сеттер состояния, каждый новый путь отмены - ещё одно место, где проверку можно забыть. В доменном объекте правило проверяется в методе, через который проходит любая отмена. А если такой путь появится в отдельном приложении (например, в ночной загрузке заказов от партнёров), доменный модуль без зависимостей подключается к нему целиком, не требуя ни базы, ни Spring.
Решения принимаются по данным из разных источников. Например, скидка покупателю зависит от суммы его заказов, которая хранится в вашей базе, и от уровня в программе лояльности, которую ведёт внешний сервис. Правилу удобно видеть покупателя одним объектом с обоими значениями. Сущность так не устроена: она описывает одну таблицу, и сведения извне в неё можно положить только в поля, помеченные «не сохранять» (@Transient) и заполняемые вручную. Доменный объект адаптер собирает из двух источников, и правило не знает, что один из них - база, а другой - сеть.
Если ни один из этих признаков не про ваш проект и правил немного, отдельная модель сейчас не нужна. Начните с привычного или переходного варианта: перейти к отдельной модели можно в любой момент, по одному объекту. Порядок разобран в разделе «Как перейти, не останавливая работу». Делать это заранее, «чтобы потом не переделывать», незачем: пока правил мало, переделывать почти нечего.
Что выбрать для нашей платформы
Приложим всё это к примеру статьи. Перечислим задачи платформы и отметим, в каких код принимает решения.
| Задача |
Принимается ли решение |
Что делает код |
| Запись на курс |
да |
считает активные записи, сравнивает с тремя, может отказать |
| Отмена записи |
да |
проверяет состояние: пройденный курс отменить нельзя |
| Экран «мои курсы» |
нет |
читает строки и показывает на экране |
| Каталог программ и запусков |
нет |
читает строки и показывает на экране |
| Панель администратора: завести программу, запуск |
нет |
принимает форму и сохраняет строку |
Решения принимаются в двух задачах из пяти, и обе касаются одного объекта - записи на курс. Это случай из середины: правила уже есть, но их немного, и собраны они вокруг одного объекта.
Почему не привычный вариант. Казалось бы, ради двух правил что-то менять незачем. Но вспомним тест правила про три курса из раздела про моки. При заглушке из трёх активных записей он одинаково проходит и на исправном сервисе, и на сервисе, из которого удалили отбор активных записей. Тест главного правила платформы не падает, когда правило сломано. Дописать тест со второй строки таблицы можно, но он поймает только ту поломку, которую автор предугадал. Надёжнее перенести отбор активных записей в запрос и проверить его тестом на настоящей базе, а для тестов правила завести реализацию порта в памяти и сверить её с настоящей общими проверками порта. Для этого нужен порт, а в привычном варианте его нет.
Второй довод - операции, которые сервису не нужны. Сервис записи видит три репозитория по три десятка операций, среди которых удаление всей таблицы. На платформе, где таблица записей - это история обучения всех пользователей, такая операция в коде правил ни к чему.
Почему переходного варианта сегодня достаточно. Пройдём по четырём признакам. Правила простые и пока не меняются. Схему таблиц платформы придумываете вы сами, снаружи её никто не задаёт. Приложение одно, и работает оно через браузер. Все данные, по которым принимаются решения, лежат в своей базе. Ни один признак не сработал.
Что нужно сделать, показано в разделе о переходном варианте: три коротких интерфейса в домене (CourseParticipations, Users и CourseRuns) и наследование от них в трёх интерфейсах Spring Data. Сущности прежние, второго набора классов и маппера нет. Взамен сервис записи видит пять операций вместо трёх наборов по три десятка, @Query уезжает в инфраструктуру, а тест правила работает с реализацией порта.
Запрет отменять пройденный курс при этом остаётся в сервисе, и это осознанная уступка. Пока путь отмены один (пользователь нажимает кнопку «отменить»), проверка тоже одна, и повторять её негде.
Почему не отдельная модель сразу. Посчитаем, во что она обойдётся здесь. Для записи на курс - шесть файлов вместо двух и маппер, который придётся править с каждым новым полем. Получить за это можно одно: домен перестанет знать разметку таблицы. Сегодня это знание правилам не мешает. Правило про три курса не обращается ни к колонкам, ни к связям, а сама запись (пять полей: идентификатор, две связи, состояние и дата) вряд ли будет часто меняться. Шесть файлов решали бы задачу, которой у платформы сегодня нет.
Когда решение придётся пересмотреть. Каждый из четырёх признаков на этой платформе может выглядеть вполне конкретно.
Лимит начинает зависеть от тарифа. Было «не больше трёх активных курсов». Стало: на бесплатном тарифе три, на платном без ограничений, на корпоративном - сколько оплатила компания, а курсы, которые компания назначила сотрудникам обязательными, в лимит не входят. Правило разрастается и меняется по решению отдела продаж, а таблица записей остаётся прежней. Это первый признак: правила меняются чаще схемы. Держать такое правило в коде, который работает с сущностями и их разметкой, становится неудобно: каждая правка тарифов идёт через файлы, связанные с устройством таблиц. С отдельной моделью сценарий записи работает только с доменными классами, и правило меняется отдельно от хранения.
Появляются новые пути отмены. Администратор отменяет записи вручную; при закрытии запуска курса отменяются все его записи; при возврате денег - записи пользователя. В каждом пути должен действовать запрет отменять пройденный курс. В переходном варианте проверка живёт в сервисе, а у сущности открыт setStatus, так что каждый новый путь - ещё одно место, где проверку можно забыть. Это третий признак: одно правило во многих местах. С отдельной моделью запрет проверяется в методе cancel, и другого способа отменить запись у сценариев нет. Если же отмену делает отдельное приложение (скажем, ночная обработка файлов, которые присылает корпоративный клиент), доменный модуль подключается к нему целиком, вместе с правилом.
Оплата уезжает во внешний сервис. Записаться можно только с оплаченной подпиской, а сведения о подписках хранит платёжная система; в базе платформы их нет. Пока нужно одно значение («оплачена ли подписка»), хватит ещё одного порта, и переходный вариант с этим справится. Но когда правилу нужен пользователь целиком (курсы из своей базы, тариф и дата окончания подписки из платёжной системы), удобнее собрать его доменным объектом из двух источников, чем дописывать в сущность поля, которых нет в таблице. Это четвёртый признак.
Платформу разворачивают поверх чужой базы. Крупный клиент ведёт сотрудников и обучение в своей системе и менять в ней ничего не даёт. Колонки там называются F_USR_ID и C_STAT, половина полей платформе не нужна, а состояние хранится числом, где 2 означает «отчислен». Если правила работают прямо с сущностями этой таблицы, в коде платформы появятся F_USR_ID и проверки вида «состояние равно двум». Это второй признак, и отдельная модель здесь нужна: у доменного объекта понятные имена и состояние типа ParticipationStatus, а перевод из чужой схемы собран в одном маппере.
Пока ничего из этого не случилось, переходного варианта достаточно. Когда случится, переход делается по одному объекту и не требует останавливать работу над задачами; порядок разобран в разделе «Как перейти, не останавливая работу».
Уровни строгости
До сих пор речь шла о том, как написать код. Остался вопрос, как сохранить написанное. Через полгода правок в доменный класс легко вернётся импорт из инфраструктуры: по невнимательности, ради быстрого исправления или просто потому, что среда разработки сама предложила подходящий класс из чужого пакета.
Удержать границу помогают разные средства, и различаются они строгостью - тем, насколько трудно нарушить границу незаметно. Разберём три, которые встречаются чаще других. Код во всех трёх случаях устроен одинаково: порт в домене, реализация в инфраструктуре. Различается то, кто заметит нарушение.
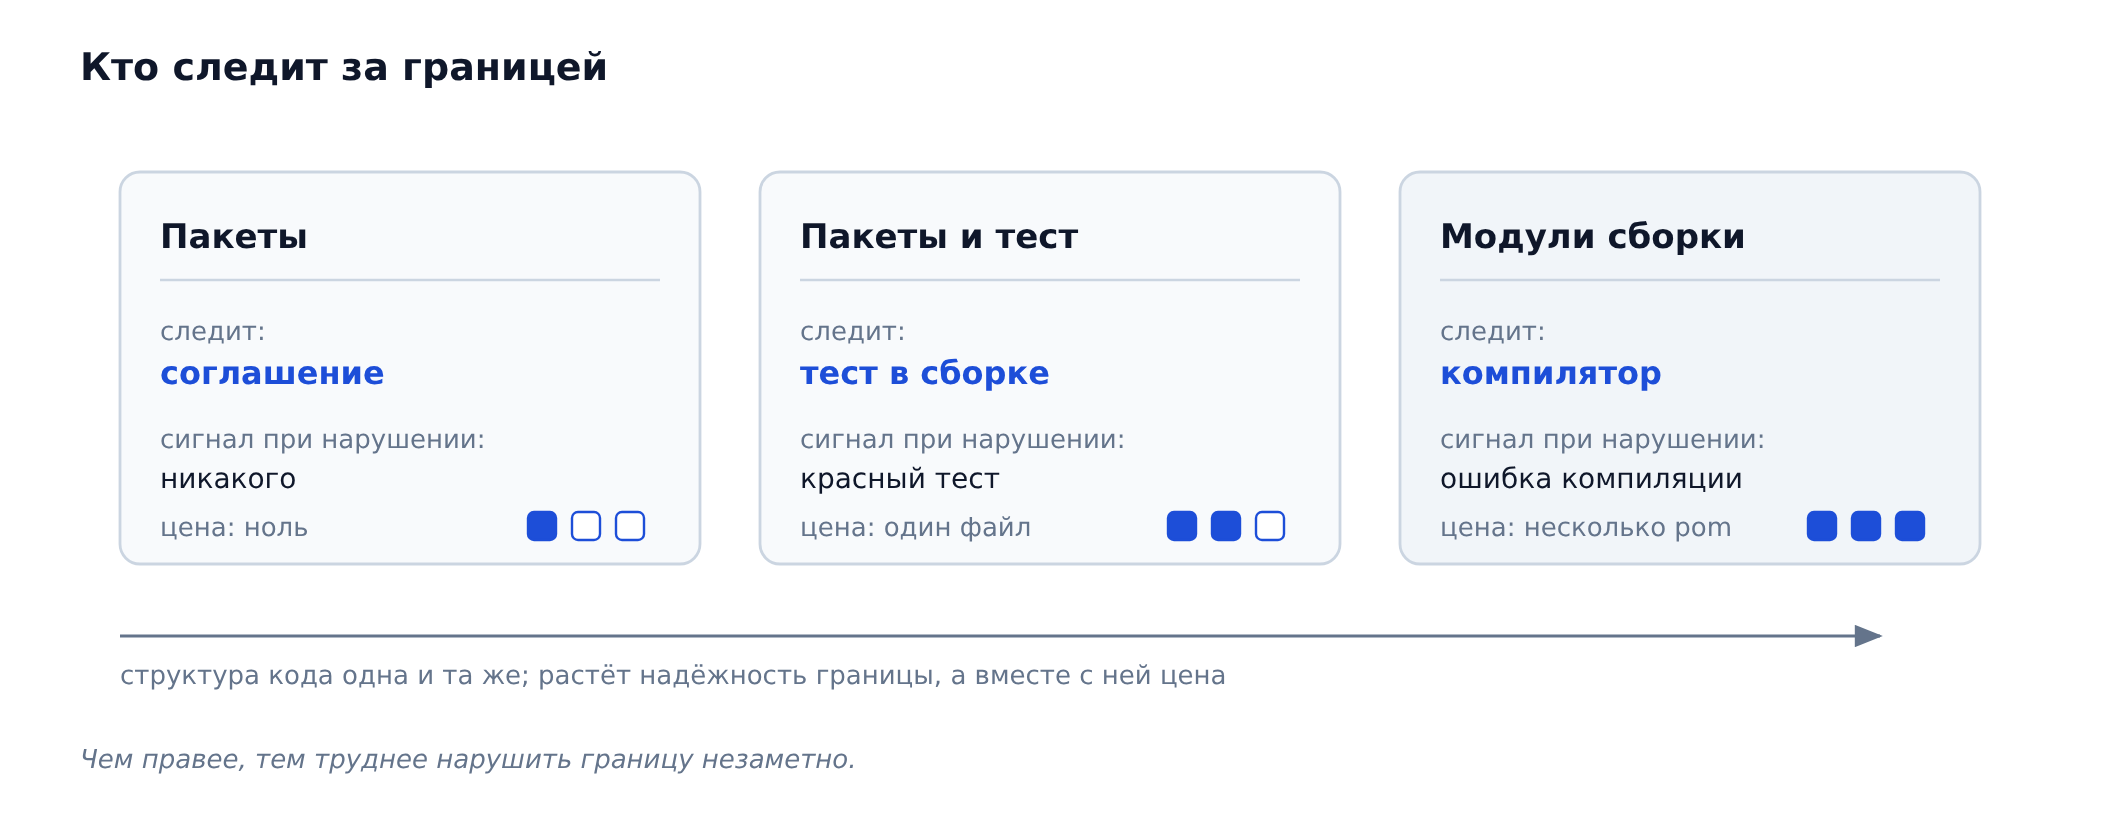
Рисунок 2. Код во всех трёх случаях один и тот же - меняется то, кто замечает нарушение границы: люди, тест или компилятор. Чем правее, тем больше настройки и тем труднее нарушить границу незаметно.
Пакеты
Пакет в Java - папка с классами, имя которой входит в полное имя класса: com.example.courses.domain.CourseParticipation. На этом уровне порт лежит в пакете domain, адаптер - в пакете persistence, и оба - в одном модуле сборки.
Следить за границей здесь некому. Компилятор не возразит против импорта из persistence в domain: модуль один, и открытые классы видны друг другу. Граница держится на том, что все в команде о ней помнят.
Ничего, кроме внимания людей, этот уровень не требует: разложить классы по пакетам среда разработки позволяет командой перемещения.
Пакеты и тест
Те же пакеты плюс тест, который проверяет границу при каждой сборке. Такие проверки умеет ArchUnit - библиотека для тестов, которая читает скомпилированные классы и проверяет, какие классы от каких зависят:
class ArchitectureTest {

    private final JavaClasses classes = new ClassFileImporter()
        .withImportOption(ImportOption.Predefined.DO_NOT_INCLUDE_TESTS)
        .importPackages("com.example.courses");

    @Test
    void домен_не_знает_про_фреймворки() {
        noClasses()
            .that().resideInAPackage("..courses.domain..")
            .should().dependOnClassesThat()
            .resideInAnyPackage("org.springframework..", "jakarta.persistence..",
                                "..courses.persistence..")
            .because("домен описывает правила предметной области "
                   + "и не должен зависеть от способа хранения")
            .check(classes);
    }

    @Test
    void сценарии_не_знают_про_инфраструктуру() {
        noClasses()
            .that().resideInAPackage("..courses.application..")
            .should().dependOnClassesThat()
            .resideInAnyPackage("..courses.persistence..",
                                "org.springframework.data..",
                                "jakarta.persistence..")
            .because("сценарий работает с портом, а не с базой")
            .check(classes);
    }
}
Первый тест запрещает классам из пакета домена зависеть от Spring и JPA. Второй запрещает сценариям обращаться к инфраструктуре, к Spring Data и к JPA. Добавил кто-то запрещённый импорт - тест падает, и сборка не проходит. В because записана причина запрета: она попадёт в сообщение об ошибке, и человек, увидевший упавший тест через год, узнает не только что запрещено, но и почему.
Этот тест написан для варианта с отдельной моделью. В переходном варианте сущности с аннотациями JPA законно лежат в домене, поэтому jakarta.persistence.. из первого правила убирают; подробнее - в разделе «Как перейти, не останавливая работу», на пятом шаге.
Обходится это одним файлом и несколькими секундами на каждой сборке. Взамен граница перестаёт зависеть от памяти людей. Нарушают её обычно не намеренно, а по невнимательности, и тест ловит как раз такие случаи.
Модули сборки
Код разнесён по подпроектам Maven, как в варианте с отдельной моделью. В pom.xml доменного модуля одна зависимость - библиотека для тестов:
<artifactId>courses-domain</artifactId>

<dependencies>
    <dependency>
        <groupId>org.junit.jupiter</groupId>
        <artifactId>junit-jupiter</artifactId>
        <scope>test</scope>
    </dependency>
</dependencies>
Здесь за границей следит компилятор. Написать @Entity в доменном коде нельзя: этой аннотации нет среди того, что доступно модулю при компиляции. Сослаться из домена на инфраструктуру тоже нельзя: инфраструктура уже зависит от домена, и Maven откажется собирать модули, которые ссылаются друг на друга по кругу.
В третьей части серии предложена проверка, настоящая ли инверсия: удалить модуль хранения из сборки и попробовать скомпилировать модуль с бизнес-логикой. Здесь её можно выполнить буквально. Уберите courses-persistence из сборки и соберите домен. Собрался - инверсия настоящая.
Обходится этот уровень дороже теста: несколько файлов pom.xml, более долгая полная сборка, а переносить классы между модулями сложнее, чем между пакетами. И есть требование к именам пакетов. Запуском приложения занимается Spring Boot (надстройка над Spring, которая собирает приложение с готовыми настройками). Классы приложения Spring Boot ищет в пакете, где лежит класс с аннотацией @SpringBootApplication, и во всех вложенных в него пакетах. Если у модулей разные корневые пакеты, область поиска придётся перечислять вручную, аннотациями @ComponentScan, @EnableJpaRepositories и @EntityScan. Проще дать всем модулям общий корень, как здесь: com.example.courses.
| Уровень |
Кто замечает нарушение |
Во что обходится |
Когда выбирать |
| Пакеты |
люди, если помнят |
ничего не стоит |
небольшой проект, который пишет один человек |
| Пакеты и тест |
тест при каждой сборке |
один файл |
почти всегда |
| Модули сборки |
компилятор |
несколько pom.xml, сборка дольше |
домен нужно собирать без инфраструктуры |
Начинать стоит со второй строки - с пакетов и теста. Первая годится для небольшого проекта, который пишет один человек: следить за границей там и так некому, кроме автора. В модули сборки код чаще всего выносят в двух случаях. Первый: тест границы начинает регулярно ловить нарушения, то есть запрещённые импорты то и дело пытаются добавить, и надёжнее, чтобы их не пропускал сам компилятор. Второй: появилась причина собирать домен отдельно: например, его правила понадобились второму приложению.
Для специалистов с опытом: модулями Maven способы провести границу не исчерпываются. Система модулей самой Java (файл module-info.java с объявлениями requires и exports) проверяется и компилятором, и виртуальной машиной при запуске, но в приложениях на Spring Boot встречается редко. Одна из причин механическая: исполняемый jar-файл Spring Boot хранит библиотеки вложенными jar-файлами; стандартного способа загружать их в Java нет, поэтому Spring Boot использует собственный загрузчик классов. Кроме того, приложение запускается с пути классов, где модульные границы не действуют, а многие библиотеки объявляют только Automatic-Module-Name вместо полного описания модуля. Другой способ - Spring Modulith: модулем там считается каждый пакет, непосредственно вложенный в пакет класса с @SpringBootApplication, а границы описываются аннотациями и проверяются тестом. По строгости это тот же второй уровень, только правила для теста уже написаны.
Что не нужно инвертировать
Приём легко испортить, применив его ко всему подряд. Каждый интерфейс - лишний шаг при чтении кода: переходя по вызову, читатель попадает в объявление, а не в работающий код. В третьей части серии этой цене отведён отдельный раздел; здесь разговор доходит до конкретных методов хранилища.
Вернёмся к исходному репозиторию. Метод findAllForUser обслуживал две задачи: сервис записи брал из него записи пользователя, чтобы посчитать активные, а экран «мои курсы» - чтобы показать список с названиями программ. В варианте с отдельной моделью первая задача ушла в порт (метод findActiveForUser). Вторая пока осталась без хозяина.
Решить, куда её деть, помогает один вопрос, который стоит задать каждому методу хранилища: принимает ли бизнес-логика решение по результату этого метода?
- Если да, метод идёт в порт. По активным записям сценарий решает, записывать ли пользователя на курс, поэтому
findActiveForUser - в порту.
- Если нет и результат просто показывают на экране или выводят в отчёт, метод остаётся прямым обращением к базе через Spring Data, без порта, доменного объекта и маппера.
Рисунок 3. Запись на курс проходит через правила: по прочитанным записям принимается решение. Список для экрана решений не требует и читается из базы напрямую.
Запросы для экранов
Экран «мои курсы» ничего не решает: он показывает то, что есть в базе. Если вести его данные через порт, адаптер, доменный объект и маппер, придётся написать четыре класса и ничего не получить взамен: правил, которые стоило бы отделять от хранения, здесь нет.
Таким запросам подходит прямое обращение к базе:
package com.example.courses.persistence;

public record ParticipationListItem(
        Long participationId,
        Long courseRunId,
        String programTitle,
        ParticipationStatus status,
        Instant enrolledAt) {
}
public interface ParticipationQueries
        extends Repository<CourseParticipationEntity, Long> {

    @Query("""
        select new com.example.courses.persistence.ParticipationListItem(
                   p.id, r.id, prog.title, p.status, p.enrolledAt)
          from CourseParticipationEntity p
          join p.courseRun r
          join r.program prog
         where p.user.id = :userId
         order by p.enrolledAt desc
        """)
    List<ParticipationListItem> findForUser(@Param("userId") Long userId);
}
Здесь стоит остановиться на двух решениях.
Первое: интерфейс наследует Repository, а не JpaRepository. Repository - пустой интерфейс Spring Data. Он не объявляет ни одного метода и служит только меткой: «создай для этого интерфейса реализацию». Поэтому у ParticipationQueries есть только то, что объявлено в нём самом: ни save, ни deleteAll, ни findAll. Коду, которому нужно только читать, и не нужно уметь писать; теперь это обеспечивает объявление интерфейса, а не договорённость.
Второе: вместо join fetch запрос собирает проекцию - объект, в котором только те поля, что нужны экрану. Конструкция select new ...ParticipationListItem(...) прямо в запросе говорит, из каких полей и какой объект собрать. Сущности при этом не создаются, связанные объекты не загружаются, и проблемы N+1 не возникает: подтягивать связи заранее не нужно, потому что они не нужны вовсе.
Оба типа лежат в модуле courses-persistence, в пакете com.example.courses.persistence, каждый в своём файле: ParticipationListItem.java и ParticipationQueries.java. Реализацию интерфейса, как и для любого репозитория, создаёт Spring Data при запуске приложения.
Вызывает ParticipationQueries веб-слой из модуля courses-app, причём напрямую, минуя сценарии и домен. Выглядит это так:
package com.example.courses.web;

@RestController
class MyCoursesController {

    private final ParticipationQueries queries;

    MyCoursesController(ParticipationQueries queries) {
        this.queries = queries;
    }

    @GetMapping("/users/{userId}/courses")
    List<ParticipationListItem> myCourses(@PathVariable Long userId) {
        return queries.findForUser(userId);
    }
}
@RestController сообщает Spring, что объект этого класса принимает запросы из браузера и возвращает ответ в виде данных (обычно в формате JSON). @GetMapping связывает метод с адресом, а @PathVariable берёт userId из самого адреса. Контроллер получает ParticipationQueries через конструктор и возвращает то, что отдал запрос: решать здесь нечего.
Из-за этого интерфейс, в отличие от адаптера, объявлен public: его имя нужно другому модулю, courses-app. Сценариям пользоваться им не положено: они работают через порт. При раскладке по модулям нарушить это не даст уже компилятор, ведь модуль сценариев от инфраструктуры не зависит. При раскладке по пакетам сработает общий запрет из раздела «Уровни строгости»: он не пускает сценарии во весь пакет persistence. Но запрет можно сформулировать и точнее: не «сценариям нельзя в инфраструктуру», а «запросами для экранов не пользуется никто, кроме веб-слоя». Для этого в тест границы добавляется ещё одно правило:
@Test
void запросы_для_экранов_вызывает_только_веб_слой() {
    noClasses()
        .that().resideOutsideOfPackages("..courses.web..", "..courses.persistence..")
        .should().dependOnClassesThat().haveSimpleNameEndingWith("Queries")
        .because("запросы для экранов идут в базу мимо правил; "
               + "пользоваться ими может только веб-слой")
        .check(classes);
}
Правило опирается на соглашение об именах: всё, что читает данные для экранов, называется ...Queries, и новый интерфейс запросов попадёт под запрет без правки теста. Пакет persistence исключён из проверки, потому что сами интерфейсы запросов лежат в нём. Если кто-то обратится к ParticipationQueries из сценария или из доменного класса, тест упадёт с сообщением из because.
Так у одного репозитория привычного варианта появилось два преемника с разными задачами: порт на три операции для правил и интерфейс запросов для экранов. Интерфейс Spring Data за портом тоже остался, но его видит только адаптер.
Не нарушает ли прямой запрос разделение?
Здесь напрашиваются три вопроса. Разберём их по очереди.
Не ломает ли запрос для экрана то разделение, ради которого всё затевалось? Нет, и это видно по направлению зависимостей:
courses-app (веб-слой) ──▶ courses-persistence ──▶ courses-domain
                                                    (ни от кого)
Разделение запрещает домену и сценариям зависеть от хранения. Запрос для экрана этого запрета не нарушает: он лежит в инфраструктуре, а пользуется им веб-слой, который и так зависит от всех трёх модулей, потому что собирает из них приложение. Домен по-прежнему собирается в одиночку, и в нём не появилось ни одной строки о таблицах.
Цена у такого решения есть: экран знает устройство таблиц, и переименование колонки заденет запрос для экрана. Но это код экрана; файл с правилом про три курса останется прежним, а ради этого разделение и делалось.
Следить нужно за другим. Как только экран начинает что-то решать (например, показывать кнопку «Отменить» только у тех записей, которые разрешено отменить), это уже бизнес-правило. Его нельзя дописывать в запрос или в шаблон страницы: ответ должен приходить из домена, иначе одно правило окажется записано в двух местах.
Разве ParticipationListItem - не тот же маппер? Нет. ParticipationListItem - результат переноса, то есть объект с данными, как и доменный CourseParticipation. Роль маппера здесь играет сам запрос: выражение select new ...ParticipationListItem(p.id, r.id, prog.title, p.status, p.enrolledAt) говорит Hibernate, какие колонки взять и в какой конструктор их передать. Сравним два пути:
- через правила: строка таблицы → сущность → маппер
toDomain → доменный объект;
- для экрана: строки таблиц →
select new → ParticipationListItem.
Во втором пути один шаг вместо трёх, и сущности не создаются вовсе.
Почему бы не вести экран через порт? Можно, но экран от этого ничего не получит, а домен кое-что потеряет.
Первое: доменному объекту не хватает данных. У CourseParticipation нет названия программы, только courseRunId, потому что правилам название не нужно. Чтобы показать список через порт, пришлось бы либо добавить в доменный объект поле ради экрана (и тогда домен начал бы меняться вслед за дизайном страниц), либо объявить в порту отдельный тип для экрана (и тогда домен знал бы про экраны).
Второе: порт начал бы расти. Сейчас в нём три метода, нужные правилам. Каждый новый список, фильтр и сортировка добавляли бы в него метод, и порт постепенно превратился бы в копию JpaRepository: правила снова видели бы десятки ненужных им операций.
Третье: защищать нечего. Порт даёт правилам независимость от хранения и проверку без базы. Правил на экране нет, а проверять у него нужно сам запрос (правильно ли соединены таблицы, верна ли сортировка), и такой тест в любом случае идёт на настоящей базе.
Через домен экран стоит вести в двух случаях. Первый: экран показывает то, что вычисляют правила, например «осталось одно место из трёх» или «запись можно отменить». Второй: данные для экрана приходят не из вашей базы, а из внешнего сервиса; тогда нужен интерфейс, но объявленный для экрана, а не доменный порт.
У такого устройства есть название - CQRS (от английского Command Query Responsibility Segregation, «разделение ответственности команд и запросов»): изменения идут через правила, чтение для показа идёт напрямую. Здесь оно применено в самой простой форме: база одна, разделены только пути в коде.
Классы, которые меняются вместе
Второе место, где интерфейс обычно лишний, - связь между классами, которые лежат в одном модуле и меняются вместе. Пусть на платформе есть класс, который считает стоимость курса, и класс, который применяет к ней скидку. Оба в домене, оба меняются, когда отдел продаж пересматривает цены, и выходят в одной версии приложения. Интерфейс между ними ничего не даёт. Он нужен, чтобы одну сторону можно было заменить, не трогая другую, а заменять нечего: второго способа считать стоимость в системе нет.
Напрашивается возражение: а вдруг появится? Тогда сработает ориентир из третьей части: инвертировать стоит там, где можно внятно назвать второй возможный вариант реализации. Как только второй способ расчёта можно назвать, интерфейс оправдан, и основную часть работы по его извлечению из класса сделает среда разработки. Заводить его заранее, под предположение, - значит сразу платить лишним шагом при чтении кода и ничего пока не получать.
С хранилищем дело обстоит иначе: вторая реализация у него есть с самого начала: реализация в памяти для тестов. Настоящее хранилище ходит в базу, и без замены тест правила пришлось бы запускать вместе с базой. Расчёт стоимости в тесте вызывается напрямую: он ничего не читает извне, и заменять его незачем.
Как перейти, не останавливая работу
Переписывать весь проект за один заход незачем, да и не выйдет: задачи не перестанут приходить на время переделки. Двигаться можно по шагам, и каждый шаг укладывается в обычную рабочую задачу.
Шаг первый. Выберите один объект предметной области. Лучше тот, что меняется чаще других: на нём быстрее станет видно, что даёт переделка. А если где-то ошибиться (скажем, отправить в порт лишний метод), ошибка затронет одну задачу, а не десять.
Шаг второй. Разделите методы его репозитория. Тем самым вопросом из раздела «Что не нужно инвертировать»: принимает ли бизнес-логика решение по результату метода. Это упражнение на бумаге, код оно не трогает. Обычно выходит так: два-три метода - в порт, остальные - в интерфейс запросов для экранов.
Шаг третий. Объявите порт и переведите на него сервисы. Пока без отдельной модели: интерфейс Spring Data наследует порт, как в переходном варианте. Работы немного: объявить интерфейс в домене и поменять типы в конструкторах сервисов, которые пользуются репозиторием. Зависимость этих сервисов от Spring Data исчезает сразу.
Шаг четвёртый. Напишите вторую реализацию порта и переведите на неё тесты правил. На этом шаге появляется польза, которую видно в ежедневной работе: тесты правил перестают опираться на мок чужого интерфейса и работают с вашей собственной реализацией - одной на все сервисы. Сверьте её с настоящим хранилищем общими проверками порта, как описано в разделе «Тест, которому не нужна база». Если дальше не идти, сделанного уже достаточно, чтобы переделка оправдалась: сервисы не зависят от Spring Data, а тесты правил не требуют базы и не прячут в заглушках предположений о запросах.
Шаг пятый. Поставьте тест на границу. Тест ArchUnit для одного пакета - того, где лежит выбранный объект. На этом шаге правило запрещает домену только org.springframework... Пакет jakarta.persistence.. добавляется в запрет после шестого шага, иначе тест упадёт на @Entity, которой на этой ступени в домене место. Такой тест не даст сделанному откатиться назад, пока вы заняты другими объектами.
Шаг шестой, если нужен. Разделите модели. Доменный объект без аннотаций, сущность отдельно, маппер между ними. Здесь впервые станет видно, во что обходится маппер на живом объекте: сколько в нём кода и как часто его приходится править вместе с полями. Решение про остальные объекты получится принимать, зная это, а не по общим соображениям.
Шаги идут в таком порядке не случайно: каждый полезен сам по себе и не требует следующего. Остановиться после любого можно, и ни один не придётся отменять, чтобы продолжить. Шестой шаг, правда, правит сделанное раньше: в объявлениях порта Long сменяется на ParticipationId и UserId, сущность - на доменный объект, а в тест границы добавляется jakarta.persistence... Но порт, его реализация в памяти и тесты остаются на своих местах.
Практический ориентир: после третьего шага поищите в файлах сервисов org.springframework.data, JpaRepository, Pageable и имена интерфейсов Spring Data. Пусто - шаг сделан. Что-то нашлось - порт пока только для вида. Искать в сервисах @Entity бесполезно: эта аннотация стоит на классе сущности, а не на сервисе, и поиск ничего не найдёт ни до переделки, ни после.
Типичные ошибки
Вот четыре частых способа провести инверсию формально и не получить того, ради чего она делается. Первые две разобраны в третьей части серии на другом примере, остальные две встречаются именно в проектах на Spring.
Порт, повторяющий JpaRepository. Интерфейс объявлен в домене, но содержит findAll, deleteById, count и saveAll про запас. Пользы от него нет: правила снова получили те же операции, только перечисленные вручную. Порт описывает то, что нужно вызывающей стороне, а не то, что умеет реализация.
Порт в модуле инфраструктуры. Интерфейс лежит рядом с реализацией, а сервисы с правилами импортируют его оттуда. Зависимость осталась направленной от правил к хранению, просто классов в системе стало больше. В третьей части этому посвящён раздел «Кому принадлежит интерфейс», и вывод там такой: интерфейс стоит объявлять в модуле, который им пользуется, а не в том, который его реализует.
Типы Spring Data в объявлениях методов порта. Один Pageable в объявлении - и доменный модуль больше не собирается без Spring Data. Порт формально на месте, а зависимость вернулась.
Сущность, пришедшая в домен через параметр. Порт объявлен правильно, но один из его методов принимает класс с @Entity, потому что так проще было написать адаптер. При разнесении по модулям сборки такой код даже не соберётся, а при разнесении по пакетам соберётся, и домен окажется зависим от JPA. По сути это переходный вариант, только решение о нём не принималось и нигде не записано.
Три из четырёх ошибок ловятся механически. Если модули домена и сценариев не собираются без courses-persistence, порт лежит не там. Если доменный модуль не собирается, когда из его pom.xml убраны все зависимости, кроме тестовой, в объявлениях порта есть типы Spring Data или сущности.
Порт, повторяющий JpaRepository, так не поймать: он собран из доменных типов и соберётся без ошибок. Здесь помогает только чтение: посмотрите, сколько методов объявлено в порту и сколькими из них пользуются сервисы.
Заключение
Мы начали с интерфейса Spring Data и правила «не больше трёх активных курсов». Подведём итог.
Привычный вариант не ошибочен: он даёт готовые операции, обходится одним классом на запись и хорошо знаком тем, кто работал со Spring. Платит он четырьмя следствиями: сервис зависит от разметки таблицы, получает около трёх десятков ненужных операций в каждом репозитории, проверяется только через заглушку, которая ничего не говорит о настоящем запросе, и держит правила у себя, а не в объекте, к которому они относятся. Ни одно из них не следует из задачи.
Порт - интерфейс, который объявляют правила и который лежит рядом с ними. Важнее всего в нём то, чего в нём нет. Наследование от JpaRepository, типы Spring Data и запросы не должны попадать в него ни в одном варианте: с ними интерфейс остаётся только для вида. Сущности в порту допустимы лишь в переходном варианте, и это осознанная уступка, о которой стоит помнить.
Интерфейс Spring Data при этом никуда не исчезает. Он переезжает в инфраструктуру и продолжает давать свои готовые операции, только получает их теперь адаптер, а не код правил. Туда же переезжает @Query, а вместе с ней и решение о том, каким запросом доставать данные.
Три варианта различаются не правильностью, а тем, сколько кода приходится написать и сколько сведений о базе остаётся в коде правил. Переходный закрывает два следствия из четырёх и обходится без маппера. Вариант с отдельной моделью закрывает все четыре и требует на каждый объект второго класса и маппера. Выбор зависит от того, сколько в проекте кода, принимающего решения: платформе из примера с её двумя правилами сегодня хватает переходного варианта, а к отдельной модели стоит переходить, когда лимит начнёт зависеть от тарифа, появятся новые пути отмены, данные для решений придут извне или схему продиктует чужая база.
Удержать границу помогают средства разной строгости. Пакеты полагаются на память людей, тест ArchUnit проверяет границу при каждой сборке, модули Maven передают проверку компилятору. Направление зависимостей при этом везде одно, меняется только то, кто замечает его нарушение.
Инвертировать стоит не всё. Если по результату метода бизнес-логика принимает решение, метод идёт в порт. Если он поставляет данные для экрана или отчёта, он остаётся прямым обращением к базе. Из одного репозитория обычно получаются два интерфейса, и это не компромисс: у проверки правил и у показа данных разные задачи.
Перейти можно по одному объекту, и польза появляется не в конце, а уже на третьем и четвёртом шагах из шести: сервисы перестают зависеть от Spring Data, а тесты правил - от моков. Остановиться можно после любого шага.
И проверка, которую можно провести руками за минуту: оставьте в pom.xml доменного модуля только тестовую зависимость и уберите из сборки остальные модули. Если домен собирается в одиночку, инверсия настоящая. Для переходного варианта эта проверка не годится: там в домене законно остаётся jakarta.persistence-api.
Спасибо, что дочитали до конца.
Следующая часть серии - та, что была обещана в конце третьей: функциональное программирование. Поговорим о том, почему ограничение на присваивание оказалось не причудой математиков, что такое функциональное ядро в императивной оболочке и почему хранение событий вместо текущего состояния меняет взгляд на устройство данных.
Следите за продолжением.