Введение
В конце предыдущей части мы обозначили тему продолжения: вторая парадигма - объектно-ориентированное программирование. Чем оно на самом деле является, почему полиморфизм оказался главным архитектурным изобретением за пятьдесят лет и как с его помощью развернуть направление зависимостей между модулями в нужную сторону - давайте об этом и поговорим.
Напомним исходную мысль. Мы приняли, что каждая парадигма программирования не расширяет возможности разработчика, а сознательно их ограничивает. Структурное программирование забрало неограниченные переходы, а взамен дало возможность разбирать программу на части и проверять каждую отдельно. Объектно-ориентированное забирает свободное обращение с указателями на функции. Что оно даёт взамен - главный вопрос этой статьи.
Начнём издалека, с вещи настолько обыденной, что о ней обычно не задумываются: со строки импорта в начале файла.
Зависимость исходного кода
Представим интернет-магазин. В нём есть модуль, принимающий заказ: он проверяет корзину, применяет скидки, считает налог, добавляет доставку и сохраняет результат. Назовём его ordering. И есть модуль работы с базой данных - persistence, где живёт класс PostgresOrderRepository.
Чтобы сохранить заказ, ordering обращается к persistence. А чтобы обратиться, он обязан объявить об этом компилятору:
import persistence.PostgresOrderRepository
Строка выглядит технической мелочью. На деле она закрепляет отношение между двумя частями системы, и отношение это прочнее, чем кажется.
Для тех, кто только начинает: зависимость исходного кода - это ответ на вопрос «что ещё требуется иметь под рукой, чтобы этот файл скомпилировался». Строка import сообщает компилятору: здесь используется чужой код, найди его описание. Пока такая строка есть, два модуля связаны - собрать первый без второго не получится.
Разберём, что эта связь означает для модуля ordering. Каждый пункт в перечне ниже - отдельное ограничение, и с каждым придётся жить.
Его нельзя собрать в отрыве от хранилища. Компилятору понадобится persistence, тому - драйвер базы данных, драйверу - его собственные зависимости. Правила расчёта заказа оказываются на вершине цепочки, в которой они не нуждаются.
Его нельзя проверить без базы данных. Чтобы выполнить тест на расчёт скидки, придётся поднять настоящую базу, накатить схему, подготовить записи. Логика расчёта при этом ничего не знает ни про схему, ни про записи - ей нужны три числа и правило.
Его тяжело передать другой команде. Вместе с модулем уедет вся цепочка зависимостей. Договориться о границе ответственности не выйдет: граница размазана.
Замена хранилища задевает расчёт заказа. Переход на другую базу означает правки в файлах, где написаны правила начисления скидок. Сами правила при этом не меняются ни на букву.
Обратим внимание на общее у всех четырёх пунктов. Ни одно из ограничений не следует из того, что модуль считает. Логика скидок, налогов и доставки работала бы в пустоте - ей не нужно ни хранилище, ни сеть, ни файловая система. Ограничения возникли из отношения, а не из существа дела.
Строка импорта - это симптом, а не болезнь
Здесь нужно остановиться и предупредить недоразумение, в которое легко впасть. Может показаться, что всё упирается в одну строку и дело решается её удалением: получать репозиторий через параметр, имени класса не упоминать. Это заблуждение, и довольно распространённое.
Строка импорта - форма, в которой зависимость становится видимой и проверяемой компилятором. Но сама зависимость заключается не в строке, а в знании: модуль ordering знает, что существует класс PostgresOrderRepository, знает его имя, знает набор его методов и их сигнатуры, рассчитывает на определённое поведение. Уберите строку, оставив знание, - и ничего не изменится. Код по-прежнему нельзя собрать отдельно, потому что где-то в нём упомянут тип из чужого модуля.
Настоящий вопрос звучит иначе: что именно модуль ordering обязан знать о внешнем мире, чтобы делать свою работу? Ответ: он должен знать, что заказ где-то сохраняется и откуда-то достаётся. Для расчёта этого хватает. А вот знание о том, что хранилище представляет собой реляционную базу, что обращение к ней идёт через драйвер и что класс называется PostgresOrderRepository, для расчёта заказа избыточно. Именно это избыточное знание и создаёт все четыре ограничения.
Такая формулировка задачи - отделить необходимое знание от избыточного - приведёт нас к решению. Но прежде стоит разобраться с тем, что направление зависимости вообще поддаётся выбору.
Почему направление кажется предопределённым
Строку импорта приходится писать потому, что ordering вызывает persistence. Чтобы вызвать чужой код, надо на него сослаться - иначе компилятор не найдёт, что вызывать.
Отсюда делается естественный вывод. Кто кого вызывает, диктует задача: расчёт заказа сохраняет данные, а не данные рассчитывают заказ. Если направление зависимости повторяет направление вызова, значит, и оно продиктовано задачей. Выбора у архитектора нет.
Вывод этот неверен, и в его опровержении состоит содержание статьи. Направление вызова действительно диктуется задачей. Направление зависимости - нет. Объектно-ориентированные языки дают механизм, позволяющий развернуть ссылку в исходном коде, не трогая того, кто кого вызывает во время работы программы.
Прежде чем показать механизм, придётся разобраться с определениями. Вопрос «что такое объектно-ориентированное программирование» имеет несколько распространённых ответов, и ни один из них к нашей задаче не подводит.
Три ответа на вопрос, что такое ООП
Ответ первый: объединение данных и функций
Формулировка встречается чаще других. Данные и работающие с ними функции собираются в одном месте, под одной крышей - вот и объект.
Проверим её на прочность. Определение подразумевает, что вызов o.f() принципиально отличается от вызова f(o). Отличие есть: в первом случае объект передаётся неявно, в роли получателя сообщения, во втором - явно, первым аргументом. Но это отличие в записи, а не в существе. Передавать структуру первым аргументом в функцию, которая с ней работает, программисты начали задолго до появления объектно-ориентированных языков, и никакой новой парадигмы из этого не выросло.
Здесь уместно возражение, и его стоит разобрать, а не обойти. Скажут: вызов метода делает кое-что сверх передачи объекта - он выбирает реализацию по фактическому типу. Один и тот же o.f() приведёт к разному коду в зависимости от того, что лежит в o. Возражение справедливо, но доказывает оно другое. Выбором реализации занимается полиморфизм, и к нему мы придём отдельно. Само по себе соседство полей и методов в одном классе такого выбора не создаёт.
Что до нашей задачи - она от этого определения не сдвигается. Соберите данные и функции хоть в один класс, хоть в десять: ordering по-прежнему упоминает PostgresOrderRepository, и все четыре ограничения остаются в силе.
Ответ второй: моделирование реального мира
Второй ответ звучит привлекательнее и объясняет меньше. Объекты в программе соответствуют сущностям в предметной области, код становится похож на реальность, реальность понятна - значит, понятен и код.
Трудность начинается при попытке применить это к чему-то, кроме учебных примеров с животными и фигурами. Что считать соответствием реальному миру для банковской транзакции? Для HTTP-запроса? Для индекса в базе данных или для пула соединений? У этих сущностей нет прообраза вне программы, они порождены самой техникой.
Допустим даже, что близость к предметной области действительно облегчает понимание - утверждение правдоподобное. Из него всё равно не выводится ни одного решения. Оно не подсказывает, в каком модуле объявить тип, куда направить ссылку, как разделить систему на части. А задача, с которой мы начали, требует именно таких решений.
Для тех, кто только начинает: речь не о том, что объектно-ориентированный подход бесполезен. Речь о том, чего мы ждём от определения. Хорошее определение работает как инструмент: узнав его, человек начинает что-то делать иначе. Оба ответа выше ничего в работе не меняют - потому и не удовлетворяют.
Ответ третий: три слова
Остаётся самый расхожий вариант, знакомый всякому, кто готовился к собеседованию: объектно-ориентированное программирование - это инкапсуляция, наследование и полиморфизм.
Ответ хорош тем, что называет конкретные вещи, которые можно проверить. Этим и займёмся. К каждому из трёх понятий мы подойдём с одним и тем же вопросом: помогает ли оно убрать из модуля ordering избыточное знание о хранилище.
Прежде чем начать, стоит сказать пару слов о происхождении этих понятий - история здесь объясняет многое.
Откуда всё взялось
В середине шестидесятых годов двое норвежских учёных, Оле-Йохан Даль и Кристен Нюгор, работали в Норвежском вычислительном центре в Осло над языком для имитационного моделирования. Им требовалось описывать системы, состоящие из множества взаимодействующих сущностей - очереди, корабли, порты.
За основу взяли ALGOL 60 и заметили в нём следующую возможность. Кадр стека, в котором живут локальные переменные вызванной функции, можно разместить не на стеке, а в динамической памяти. Тогда после выхода из функции её локальные переменные не исчезают - они продолжают существовать, и на них можно ссылаться.
Из этого наблюдения выросли остальные понятия. Функция, размещающая свой кадр в куче, превращается в конструктор. Её локальные переменные - в поля объекта. Вложенные в неё функции - в методы. Язык, построенный на этой идее, получил имя Simula 67; в нём впервые появились классы, объекты, наследование и виртуальные процедуры - то, что мы сегодня называем виртуальными методами. В 2001 году Даль и Нюгор получили за эту работу премию Тьюринга.
Обратим внимание на последовательность. Сначала появился механизм - объект, переживающий вызов. Потом вокруг него выстроились понятия. А слова, которыми этот подход принято объяснять сегодня, появились ещё позже и описывают не столько механизм, сколько впечатление от него. Отчасти поэтому они и объясняют так мало.
Инкапсуляция
Инкапсуляция очерчивает границу вокруг группы данных и функций. Снаружи видна лишь часть функций, данные скрыты. В объектно-ориентированных языках это выглядит привычно: приватные поля, публичные методы.
Решает ли она нашу задачу
Нет, и причина лежит на поверхности. Пометьте все поля PostgresOrderRepository как приватные, спрячьте половину методов - строка импорта в модуле ordering останется на месте. Инкапсуляция управляет тем, что видно внутри класса при его использовании. О том, кто и откуда вправе на класс сослаться, она не говорит ничего.
Разница существенная, и к ней стоит присмотреться. Инкапсуляция - средство от неосторожного обращения: она не даёт постороннему коду залезть в чужие потроха и завязаться на детали, которые автор менять не обещал. Задача достойная, но другая. Нам нужно не ограничить обращение к классу, а избавиться от обязанности его знать.
Неудобная история
Проверив инкапсуляцию на нашей задаче, стоит задержаться и отметить обстоятельство, которое обычно упускают: объектно-ориентированные языки инкапсуляцию не изобрели. В языке C она была устроена так, что скрывала больше.
Взглянем на заголовочный файл. Это всё, что видит пользователь модуля:
/* point.h */
struct Point;                                  /* объявлена, но не описана */
struct Point* makePoint(double x, double y);
double distance(struct Point* p1, struct Point* p2);
Устройство структуры живёт в отдельном файле, который наружу не выходит:
/* point.c */
#include "point.h"
#include <stdlib.h>
#include <math.h>

struct Point {
    double x, y;
};

struct Point* makePoint(double x, double y) {
    struct Point* p = malloc(sizeof(struct Point));
    p->x = x;
    p->y = y;
    return p;
}

double distance(struct Point* p1, struct Point* p2) {
    double dx = p1->x - p2->x;
    double dy = p1->y - p2->y;
    return sqrt(dx*dx + dy*dy);
}
Для тех, кто только начинает: пример на старом языке приведён ради особенности, которой в Java, C# и Kotlin нет, - физического разделения объявления и реализации на два разных файла.
Разберём, в чём здесь сила. Пользователь point.h не только не обратится к полям x и y - он не знает об их существовании. Структура объявлена, но не определена; компилятор знает, что такой тип есть, и не знает, из чего он состоит. Работа с ним идёт только через указатель.
Отсюда следует свойство, в Java, C# и Kotlin недостижимое. Переименуйте поля, добавьте третье, смените типы, поменяйте порядок - вызывающие модули не потребуют перекомпиляции. Достаточно пересобрать файл реализации и выполнить сборку заново.
Проверяется это за несколько минут, и опыт стоит повторить. Соберите объектный файл вызывающего модуля и запомните его контрольную сумму. Затем перепишите структуру до неузнаваемости - переименуйте оба поля, добавьте ещё два, смените double на float. Пересоберите только файл реализации и слинкуйте программу со старым, нетронутым объектным файлом вызывающего модуля. Программа работает, контрольная сумма не изменилась. В машинном коде вызывающего модуля нет ни размеров, ни смещений - лишь адреса функций и передача указателей.
Что произошло потом
В C++ появились классы, а вместе с ними требование описывать поля в заголовочном файле:
// point.h
class Point {
public:
    Point(double x, double y);
    double distance(const Point& p) const;
private:
    double x;       // теперь поля видны всем, кто подключит заголовок
    double y;
};
Компилятор по-прежнему запрещает обращаться к x и y извне. Но они написаны в файле, который читают все клиенты, и переименование поля заставит пересобрать каждого из них. Сокрытие, которое в C было полным, стало частичным: имена видны, прямой доступ закрыт.
Справедливости ради: приём обхода существует и называется pimpl. В заголовке остаётся объявление вложенной структуры и указатель на неё, а поля уезжают в файл реализации. Сокрытие восстанавливается в прежнем объёме. Платить за это приходится дополнительным выделением памяти при создании объекта и потерей встраивания при вызовах. В C инкапсуляция получалась сама собой из устройства языка; в C++ её приходится выстраивать осознанно и не бесплатно.
Java, C# и Kotlin отменили разделение на объявление и реализацию вовсе - класс описывается в одном файле целиком. Приватное поле держится на обещании компилятора, а на виртуальной машине Java вызов setAccessible(true) снимает это обещание в три строки.
Вывод получается неожиданным для привычной картины: средства языка инкапсуляцию скорее ослабили. Держится она не столько на языке, сколько на договорённостях внутри команды - на согласии не обходить ограничение, которое обойти технически несложно.
Где инкапсуляция всё-таки работает
Из сказанного не следует, что она не нужна. Следует другое: искать её стоит не на уровне класса, а на уровне модуля. И вот там она работает по-настоящему.
Граница, способная удержать, проходит по единице сборки. В Kotlin за это отвечает модификатор internal:
// модуль billing

// Видно всем, кто подключил модуль
interface InvoiceCalculator {
    fun calculate(order: Order): Invoice
}

// Видно только внутри модуля billing
internal class DefaultInvoiceCalculator(
    private val taxPolicy: TaxPolicy
) : InvoiceCalculator {
    override fun calculate(order: Order): Invoice { /* ... */ }
}
Модулем документация Kotlin называет набор файлов, компилируемых вместе: модуль IntelliJ IDEA, проект Maven, исходный набор Gradle. Соседний модуль на DefaultInvoiceCalculator не сошлётся - компилятор не пропустит: за пределами своего набора файлов такого имени для него не существует.
Сравним два уровня защиты. Приватное поле просит не трогать - и остаётся просьбой, обходимой рефлексией за несколько строк. Отдельный модуль со скрытыми классами не даёт дотянуться, потому что имя класса не входит в публичный интерфейс библиотеки. Первое - соглашение, второе - ограничение. В предыдущей части мы видели, что архитектура строится на ограничениях; здесь это правило подтверждается буквально.
Для специалистов с опытом: есть оговорка, о которой в учебниках обычно не пишут. Запрет на обращение к internal-классу живёт на уровне компилятора Kotlin. Документация по совместимости с Java говорит прямо: internal-объявления становятся в Java публичными. Чтобы ими не воспользовались по случайности, компилятор искажает имена internal-членов, однако имена публичных членов internal-класса не искажаются и остаются вызываемыми из Java. Команде, пишущей целиком на Kotlin, границы хватает; в смешанном проекте её подпирают разделением артефактов сборки. В Java похожую роль играют пакетная видимость и, начиная с девятой версии, система модулей с файлом module-info.java, где пакет недоступен снаружи, пока не перечислен в exports.
Подведём итог: первое из трёх понятий нашу задачу не решило, хотя по дороге и обнаружилось кое-что полезное.
Наследование
Наследование позволяет объявить один класс через другой, добавив к нему своё. С этой конструкции начинается знакомство почти с каждым объектно-ориентированным языком.
Решает ли оно нашу задачу
Снова нет, и снова по причине, лежащей на поверхности. От какого бы класса ни наследовался PostgresOrderRepository, модуль ordering обязан его импортировать, чтобы создать экземпляр. Иерархия классов живёт внутри одного модуля и ничего не говорит о границах между модулями.
Вдобавок наследование приносит с собой отдельную трудность, о которой речь пойдёт ниже. Сначала посмотрим на историю - она объясняет, откуда взялась сама конструкция.
Приём, существовавший до языков
Нечто похожее на наследование программисты делали и до появления объектно-ориентированных языков, только руками. Приём таков: объявить структуру, первые поля которой в точности повторяют поля другой структуры, в том же порядке:
struct NamedPoint {
    double x, y;      /* те же два поля, что и в Point, в том же порядке */
    char* name;
};
Раскладка полей в памяти совпадает: первые шестнадцать байт NamedPoint устроены так же, как весь Point. Значит, указатель на NamedPoint можно привести к указателю на Point и передать в функцию, которая о существовании NamedPoint не подозревает:
struct NamedPoint* origin = makeNamedPoint(0.0, 0.0, "origin");
struct NamedPoint* corner = makeNamedPoint(1.0, 1.0, "upperRight");

printf("distance=%f\n",
       distance((struct Point*) origin, (struct Point*) corner));
Программа печатает distance=1.414214 - корень из двух, расстояние между началом координат и точкой (1,1). Функция distance честно прочитала первые два поля и не заметила подмены.
Примерно так же компиляторы C++ реализуют одиночное наследование: подобъект базового класса размещается в начале производного, и приведение указателя вверх по иерархии не меняет адрес. Оговорка, впрочем, нужна. Раскладку объекта диктует соглашение конкретной платформы, а не стандарт языка. С появлением виртуальных функций в начало объекта встаёт указатель на таблицу методов, и совпадение с простой структурой пропадает.
Полноценным наследованием такой приём назвать трудно. Приведение типа пишется руками, компилятор ничего не проверяет, перестановка полей ломает программу незаметно - она продолжит считать, но не то. Множественное наследование таким способом не изобразить вовсе: в начале структуры помещается только один чужой набор полей.
Языки сделали то же самое безопасным. Компилятор проверяет совместимость типов, приведение становится неявным, появляется множественное наследование интерфейсов:
open class Point(val x: Double, val y: Double)

class NamedPoint(x: Double, y: Double, val name: String) : Point(x, y)
// приведение типов не требуется, компилятор проверит сам
Улучшение заметное. Изобретением его назвать сложнее.
Про слово open
В примере выше есть деталь, мимо которой легко пройти. Без ключевого слова open перед class Point код не скомпилируется: в Kotlin класс по умолчанию закрыт для наследования, и открывать его нужно явно.
Решение это не синтаксическое, а архитектурное, и связано оно с темой статьи напрямую. Наследование создаёт между двумя классами связь более жёсткую, чем любой вызов метода. Наследник зависит не только от публичного контракта предка, но и от его внутреннего устройства: какие методы вызывают какие, в каком порядке меняется состояние, что считается инвариантом. В сигнатурах ничего из этого не записано, а значит, и не проверяется.
Следствие знакомо всякому, кто поддерживал большую иерархию. Правка в базовом классе ломает потомков, невидимых автору правки и порой ему неизвестных. Причём ломает не на этапе компиляции, где ошибку поймают сразу, а во время выполнения, в неочевидном месте.
Отсюда правило, сформулированное в 1994 году в книге «Приёмы объектно-ориентированного проектирования» Гаммы, Хелма, Джонсона и Влиссидеса: предпочитайте композицию объектов наследованию классов. Там же сказано - наследование нарушает инкапсуляцию, открывая наследнику внутренности предка.
Разница видна на простом примере:
// Сомнительно: отчёт наследуется ради пары чужих методов
class PdfReport : ReportBase() { /* ... */ }

// Лучше: отчёт получает то, что ему требуется, и ничего не наследует
class PdfReport(private val renderer: DocumentRenderer) { /* ... */ }
В первом варианте PdfReport связан с ReportBase всем, что в том классе есть, включая защищённые поля и порядок вызовов. Во втором он знает про renderer ровно то, что записано в его публичном интерфейсе, и переживёт любые изменения внутри.
Наследование остаётся уместным там, где строится иерархия типов и любой потомок подставляется вместо предка, не нарушая ожиданий вызывающего кода. Там, где иерархия служит лишь способом переиспользовать чужой код, композиция оказывается надёжнее.
Подведём промежуточный итог. Два понятия из трёх проверены. Инкапсуляция появилась раньше объектно-ориентированных языков и в них ослабла; наследование существовало как ручной приём и было улучшено, но нашу задачу не решает ни то, ни другое. Остаётся третье понятие - и с ним дело обстоит иначе.
Полиморфизм
Полиморфизм означает, что один и тот же вызов приводит к выполнению разного кода - смотря какой объект оказался на другом конце.
Применим к нашей задаче
Вернёмся к магазину и вспомним формулировку, к которой мы пришли в начале: ordering должен знать, что заказ можно где-то сохранить и откуда-то достать, и не должен знать ничего сверх этого. Запишем знание в точности в таком объёме:
interface OrderRepository {
    fun findById(id: OrderId): Order?
    fun save(order: Order)
}
Перед нами интерфейс - перечень обещаний без единой строки исполнения. Он утверждает: кто бы ни взялся исполнять роль хранилища заказов, он обязан уметь найти заказ по идентификатору и сохранить заказ. Каким образом - вопрос исполнителя.
Код расчёта принимает такое хранилище снаружи и работает с обещаниями, а не с конкретной базой:
class PlaceOrder(private val orders: OrderRepository) {

    fun execute(draft: OrderDraft): Result<Order> {
        val order = Order.from(draft).getOrElse { return Result.failure(it) }
        orders.save(order)                    // кто именно сохранит - неизвестно
        return Result.success(order)
    }
}
Исполнителей бывает сколько угодно, и PlaceOrder о них не знает:
class PostgresOrderRepository(private val db: Database) : OrderRepository { /* ... */ }

class InMemoryOrderRepository : OrderRepository { /* ... */ }   // для тестов
Для тех, кто только начинает: бытовая аналогия - электрическая розетка. Производитель чайника не знает, какая электростанция даст ток; электростанция не знает, что к ней подключат чайник. Обе стороны знают стандарт розетки: форму разъёма, напряжение, частоту. Благодаря этому чайник работает в любом доме страны, а станцию можно заменить, не меняя чайники. Интерфейс в коде устроен так же: вместо прямого провода между двумя устройствами появляется согласованная форма разъёма. Аналогия грубая, но направление мысли передаёт.
Как это устроено внутри
Понимать внутреннее устройство полезно: без этого полиморфизм остаётся магией, а магию трудно применять осознанно. Тем более что механизм придумали задолго до объектно-ориентированных языков - в предыдущей части мы уже отмечали, что объектно-ориентированный код пишут и на чистом C.
Ядро UNIX хранило таблицу драйверов устройств. Каждая запись в ней представляла собой набор указателей на функции с заранее оговорёнными сигнатурами. В шестой и седьмой редакциях структура символьного устройства cdevsw содержала пять таких указателей: открыть, закрыть, прочитать, записать и управлять устройством. Последний назывался d_sgtty и позже превратился в привычный нам ioctl. У блочных устройств была своя, более короткая таблица: открыть, закрыть и передать запрос дисковой подсистеме.
Названия и состав менялись от редакции к редакции. Неизменным оставалось главное: фиксированный набор операций с фиксированными сигнатурами, одинаковый для всех драйверов. Перед нами интерфейс, выраженный средствами языка, в котором слова «интерфейс» не было.
Соберём подобную таблицу руками:
/* Упрощение: в настоящем ядре структура называлась cdevsw,
   а поля - d_open, d_close, d_read, d_write, d_sgtty */
struct Device {
    void (*open)(char* name, int mode);
    int  (*read)(void);
    void (*write)(int c);
};
Драйвер консоли заполняет её указателями на собственные функции:
static void consoleOpen(char* name, int mode) { /* ... */ }
static int  consoleRead(void) { int c; /* ... */ return c; }
static void consoleWrite(int c) { /* ... */ }

struct Device console = { consoleOpen, consoleRead, consoleWrite };
И чтение символа сводится к вызову через указатель. Адрес функции становится известен только во время работы программы:
extern struct Device* STDIN;

int readChar(void) {
    return STDIN->read();
}
В основе полиморфизма лежит именно это - вызов функции по адресу, выбранному во время выполнения. Когда вы вызываете метод интерфейса в Kotlin, работает та же модель: обращение идёт к таблице методов, соответствующей фактическому классу объекта. Разница лишь в том, что таблицу строит и проверяет компилятор, а не программист.
Зачем понадобились языки, если механизм был
Вопрос законный, и ответ на него объясняет, почему полиморфизм называют главным приобретением парадигмы.
Разница между двумя записями не в возможностях, а в цене ошибки. Указатель на функцию легко забыть инициализировать - и программа прыгнет по случайному адресу. Легко перепутать порядок полей в структуре - и вызов пойдёт не туда, а компилятор промолчит, поскольку типы совпадают. Легко вызвать функцию в обход оговорённых правил. Ошибка такого рода проявляется далеко от места, где она сделана, и ищут её долго.
Соглашения, прежде жившие в голове программиста, языки превратили в проверяемые правила. Компилятор строит таблицу сам, подставляет адрес сам, сверяет сигнатуры сам. Полиморфизм подешевел настолько, что его стали применять повсюду, а не в двух-трёх важных местах программы.
Вот в этом смысле объектно-ориентированное программирование и накладывает ограничение на косвенную передачу управления. Оно забирает свободное обращение с указателями на функции - и взамен выдаёт механизм, за правильностью которого следит компилятор.
Программа, которой безразлично устройство мира
Прежде чем перейти к архитектурным следствиям, посмотрим на пример, ради которого всё затевалось. Вот программа копирования, написанная на C:
#include <stdio.h>

void copy(void) {
    int c;
    while ((c = getchar()) != EOF)
        putchar(c);
}
Спросим: что придётся в ней изменить, если на входе появится сканер рукописного текста, а на выходе синтезатор речи?
Ничего. Программу даже не придётся пересобирать. Её исходный код не содержит ни одной ссылки на код драйверов: обращение идёт к таблице, а таблицу заполняет тот, кто подключает устройство. Пока новое устройство предоставляет оговорённый набор функций, программа с ним работает.
Устройства ввода-вывода превратились в подключаемые модули - в плагины. И произошло это не из любви к абстракциям. В пятидесятых программы писали под конкретное устройство: прочитать колоду перфокарт, пробить новую колоду с результатом. Когда заказчики понесли данные на магнитной ленте, выяснилось, что программу придётся переписывать целиком, хотя логика обработки не изменилась ни на букву. Независимость от устройства оказалась условием выживания программы, а не украшением.
С тех пор сменились поколения техники. Задача осталась та же, с которой мы начали статью: отделить то, что составляет существо работы, от того, через что эта работа сообщается с внешним миром.
Инструмент у нас теперь есть. Посмотрим, что он делает с направлением зависимостей.
Инверсия зависимости
Для начала разведём два понятия, которые в разговоре часто сливаются в одно.
Поток управления - кто кого вызывает во время работы программы. Задаётся существом дела: расчёт заказа сохраняет данные, а не наоборот.
Зависимость исходного кода - кто на кого ссылается в тексте программы. Та самая строка import, с которой статья началась.
До появления надёжного полиморфизма эти две вещи были связаны жёстко. Главная функция вызывает функции верхнего уровня, те - функции среднего уровня, те - нижнего. А чтобы вызвать функцию, модуль обязан на неё сослаться. Обе стрелки смотрят в одну сторону.
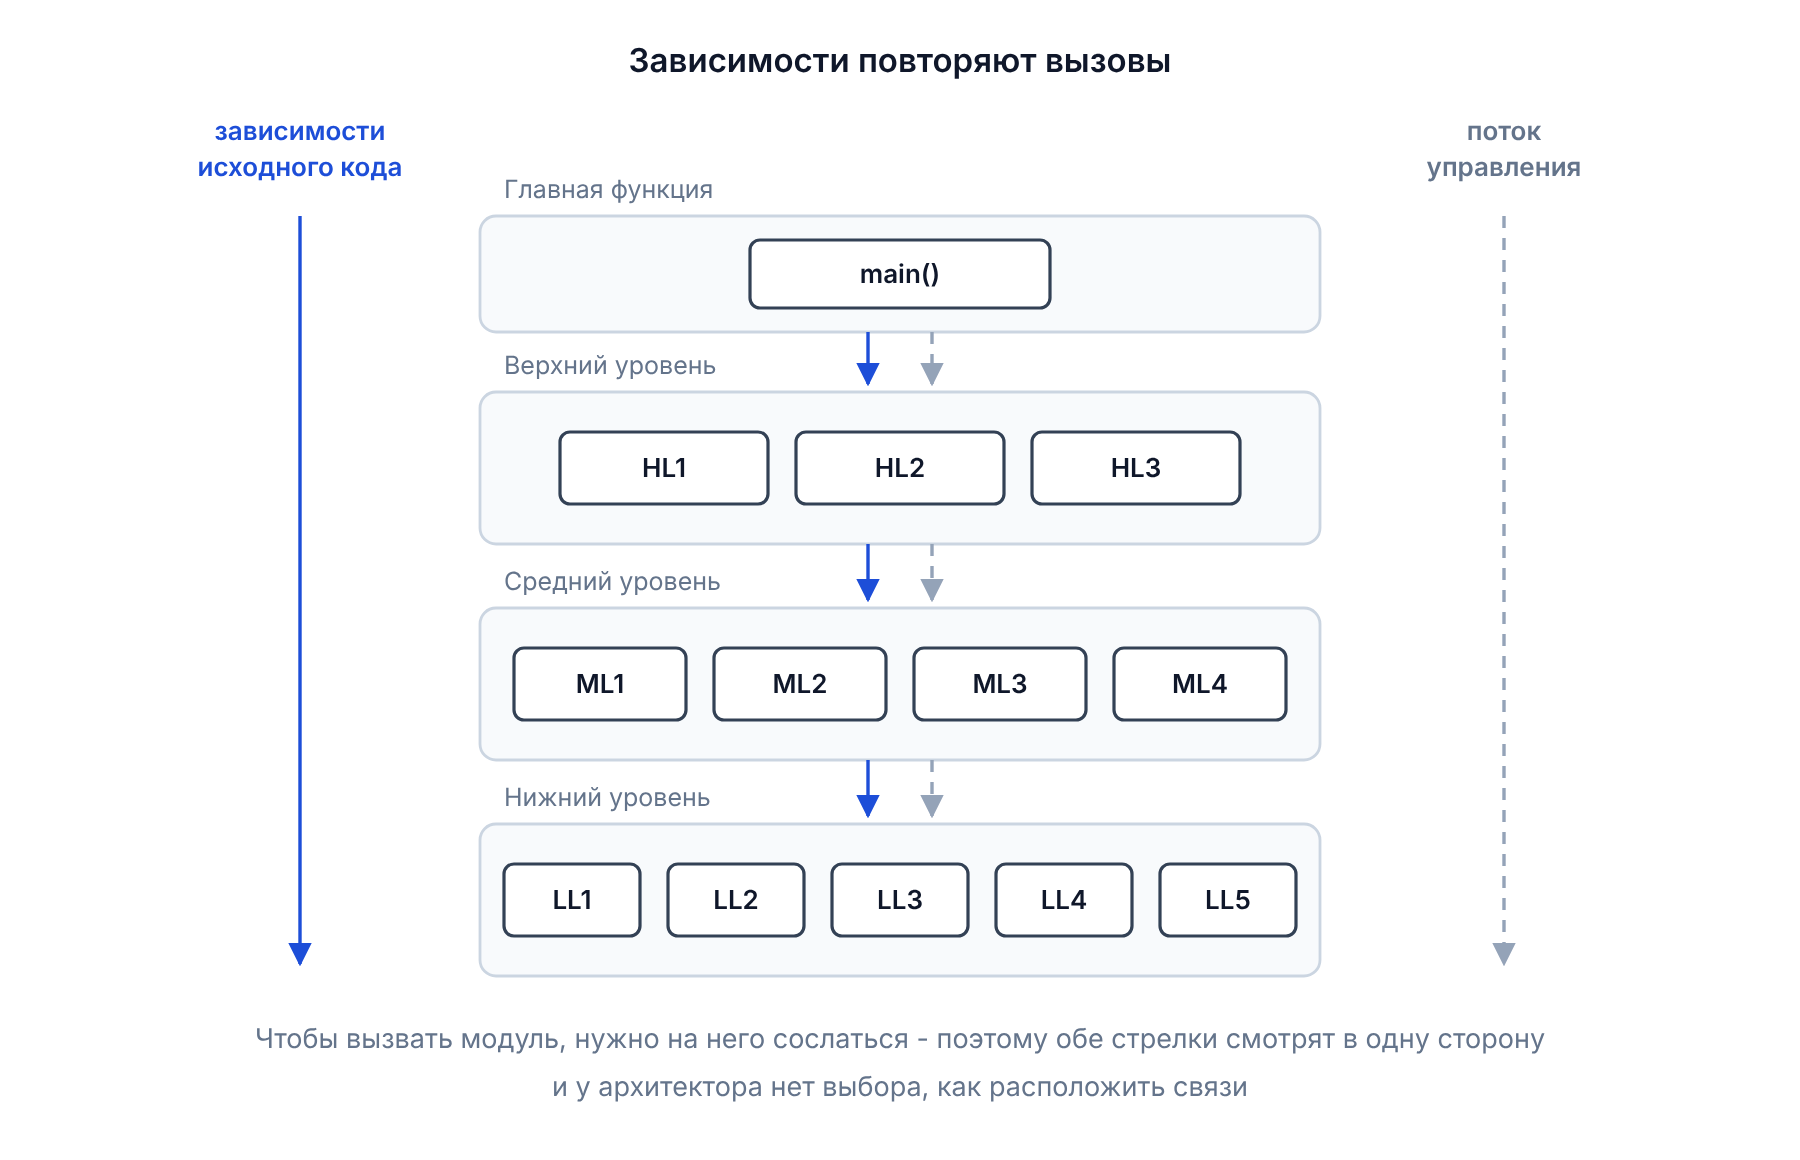
Рисунок 1. В классической многоуровневой структуре зависимость исходного кода повторяет поток управления. У архитектора нет выбора: направление связей задано тем, кто кого вызывает.
Перед нами картина, с которой статья начиналась, только нарисованная целиком. Модуль расчёта заказа вызывает хранилище - значит, импортирует его. Правила скидок оказываются привязаны к драйверу базы данных, хотя от хранилища не зависят. И так на каждом уровне.
Полиморфизм эту связь разрывает.
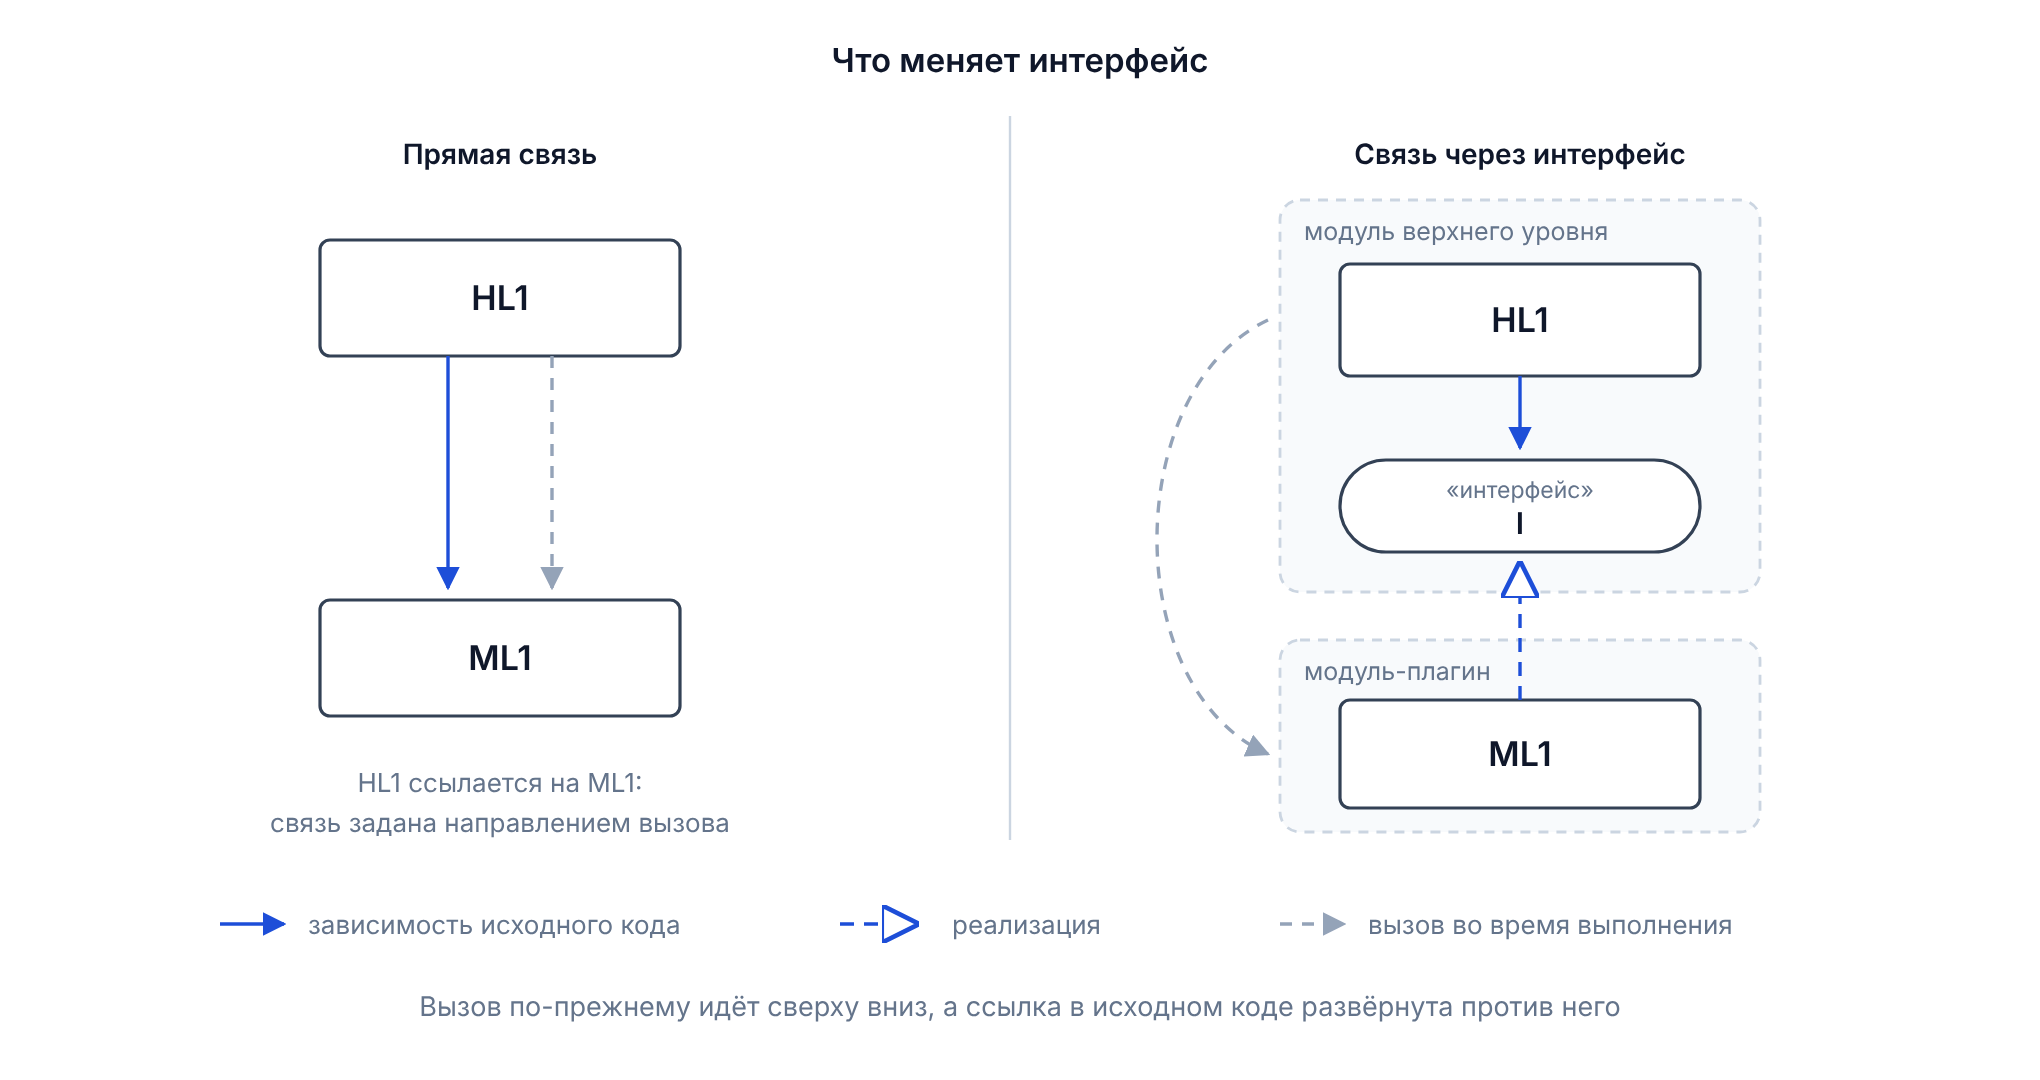
Рисунок 2. Слева прямая связь: ссылка в исходном коде повторяет вызов. Справа та же пара модулей через интерфейс. Поток управления по-прежнему идёт от HL1 к ML1, а зависимость исходного кода от ML1 направлена вверх, к интерфейсу, то есть против потока управления.
Разберём правую половину рисунка по шагам, потому что в ней вся суть.
Модуль верхнего уровня HL1 вызывает метод F(). В тексте программы он ссылается только на интерфейс I, который лежит здесь же, внутри его собственного модуля. Чужих имён в его коде нет.
Модуль ML1 этот интерфейс реализует. Чтобы написать : I в объявлении класса, он обязан на интерфейс сослаться - и ссылается снизу вверх, пересекая границу модуля.
Во время выполнения никакого интерфейса не существует. HL1 вызывает код внутри ML1 ровно так же, как вызывал бы напрямую; интерфейс - конструкция времени компиляции, уловка для сборки. Поток управления не изменился ни на шаг.
Изменилось направление зависимости в тексте программы. Теперь оно противоположно направлению вызова. Этот эффект и называют инверсией зависимости.
Посмотрим, как выглядит наш магазин после перестановки:
// ===== Модуль ordering: бизнес-правила =====
// Здесь объявлен интерфейс. Ссылок на базу данных нет

interface OrderRepository {
    fun findById(id: OrderId): Order?
    fun save(order: Order)
}

class PlaceOrder(private val orders: OrderRepository) {
    fun execute(draft: OrderDraft): Result<Order> { /* ... */ }
}

// ===== Модуль persistence: деталь реализации =====
// Ссылается на модуль ordering. Обратной ссылки нет

internal class PostgresOrderRepository(
    private val db: Database
) : OrderRepository {

    override fun findById(id: OrderId): Order? =
        db.query("SELECT ... WHERE id = ?", id.value)?.toDomain()

    override fun save(order: Order) {
        db.upsert(order.toRow())
    }
}
Сравним с тем, с чего мы начинали, и отметим, что именно изменилось.
Строка import persistence.PostgresOrderRepository из модуля ordering исчезла. Вместо неё появилась ссылка в обратную сторону: модуль persistence упоминает OrderRepository из модуля ordering. Вызов при этом идёт по-прежнему из бизнес-логики в базу - пользователь магазина оформляет заказ, расчёт просит сохранить, база сохраняет.
Вернёмся к вопросу, который мы поставили вначале: что ordering обязан знать о внешнем мире. Теперь ответ записан буквально - интерфейсом из двух методов. Знание об устройстве хранилища из модуля ушло, необходимое знание осталось.
Тот же приём применим и к остальным стрелкам с первого рисунка. Вернитесь к нему мысленно и представьте, что направление каждой задаётся отдельно, независимо от того, кто кого вызывает. Архитектор получает контроль над структурой связей в тексте программы - а эта структура, как мы говорили в первой части, и определяет стоимость будущих изменений.
Приём несложен. Возможно, поэтому его часто применяют формально, не получая обещанного результата. Об этом стоит сказать отдельно.
Кому принадлежит интерфейс
Интерфейс стоит объявлять в модуле, который им пользуется, а не в том, который его реализует.
Объявите OrderRepository в модуле persistence, рядом с реализацией, - и инверсии не получится. Бизнес-логике придётся импортировать тип из модуля базы данных: теперь уже интерфейс, а не класс. Стрелка осталась на месте, а сущностей в системе стало больше.
Проверить себя несложно. Удалите модуль persistence из сборки целиком и попробуйте скомпилировать ordering. Собралось - инверсия настоящая. Не собралось - значит, перед нами декорация.
Из того же рассуждения следует второе правило, менее очевидное. Интерфейс описывает потребность вызывающей стороны, а не возможности реализации. Разница видна на примере:
// Признак проблемы: интерфейс описывает устройство хранилища
interface OrderRepository {
    fun executeQuery(sql: String): ResultSet
    fun beginTransaction(): Transaction
}

// Лучше: интерфейс описывает потребность бизнес-логики
interface OrderRepository {
    fun findById(id: OrderId): Order?
    fun save(order: Order)
}
Второй вариант переживёт смену хранилища - хоть на документную базу, хоть на внешнюю службу, хоть на файл. Первый не переживёт: в него уже протекли понятия конкретной технологии, строка запроса и транзакция. Формально инверсия выполнена, фактически бизнес-логика по-прежнему рассуждает в терминах реляционной базы.
Распознаётся такой интерфейс по характерному признаку: он слово в слово повторяет публичные методы одного конкретного класса. Писали его, глядя на реализацию, а не на потребность. Пользы от него немного - меняться он будет ровно тогда же, когда меняется класс.
Для специалистов с опытом: стоит разделять три вещи, которые иногда путают. Инверсия зависимости - принцип, касающийся направления ссылок в исходном коде. Внедрение зависимостей - приём передачи реализации в объект, и работает он через обычный конструктор, безо всяких библиотек. Контейнер внедрения зависимостей - механика сборки объектного графа, удобная в больших системах. Подключение контейнера само по себе инверсии не даёт: при интерфейсе, объявленном не в том модуле, направление стрелок от фреймворка не зависит.
Что это даёт системе
Получив контроль над направлением зависимостей, систему выстраивают так, чтобы пользовательский интерфейс и база данных зависели от бизнес-правил, а не наоборот.
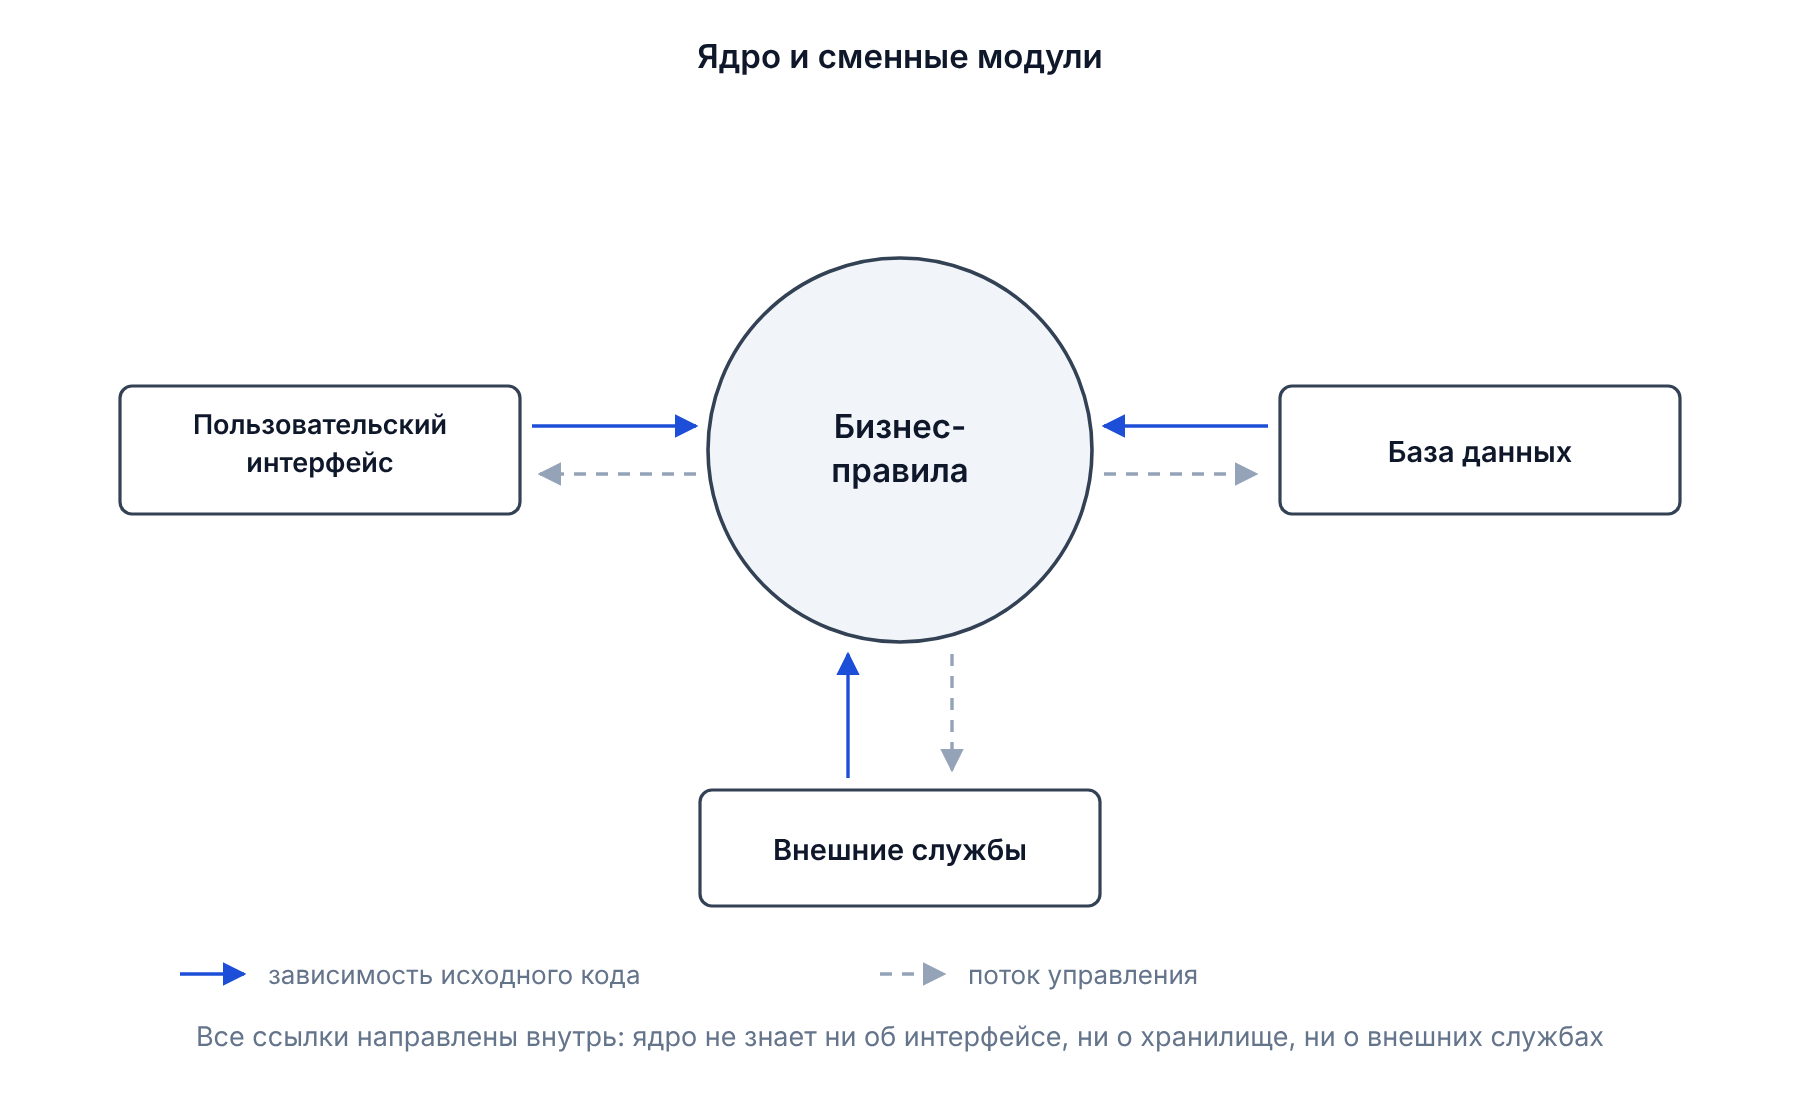
Рисунок 3. Все стрелки зависимости направлены внутрь, к бизнес-правилам, хотя поток управления идёт в обе стороны. Интерфейс, хранилище и внешние службы становятся сменными модулями вокруг неизменного ядра.
В коде бизнес-правил нет упоминаний ни об интерфейсе, ни о базе данных, ни о платёжном шлюзе. Всё это стало плагинами - подключаемыми модулями, замена которых ядра не касается. Ровно как устройства ввода-вывода для программы копирования, только на уровне целой системы.
Из такой схемы вытекают три следствия. Каждое сокращает свою статью расходов - те самые усилия на изменения, которые в первой части мы назвали мерилом архитектуры.
Независимость сборки. Бизнес-правила, интерфейс и работа с данными собираются в три отдельных модуля, и модуль бизнес-правил не зависит ни от одного из остальных.
Сокращается рабочее время. Правка задевает один модуль - пересобирается один модуль, и цикл «изменил, собрал, проверил» укорачивается. Эффект заметен не столько на отдельной правке, сколько на их количестве: за день разработчик проходит этот цикл много раз. Есть и побочное следствие: при долгой сборке её перестают запускать после каждой мелкой правки, изменения копятся пачками, и ошибки в них обнаруживаются позже, чем могли бы.
Независимость развёртывания. Изменилась реализация хранилища - пересобрать и выкатить придётся только её, остальная система не затронута.
Экономия здесь не на сборке, а на проверках и риске. Выкатывая один модуль, вы проверяете один модуль; при отказе откатываете тоже один. Объём регрессионного тестирования и площадь возможной поломки задаются не размером правки, а размером уезжающего в продакшен. В системе, собираемой целиком, однострочное изменение обходится в полную цену проверки - отсюда редкие релизы крупными партиями.
Независимость разработки. Модули, развёртываемые по отдельности, можно и писать по отдельности - разными людьми, разными командами.
Сокращается согласование. Стоимость его растёт не столько от числа людей, сколько от числа мест пересечения их работы. Интерфейс сводит переговоры к разовой договорённости: условились один раз, дальше две команды идут параллельно, не дожидаясь друг друга.
Конкретные цифры здесь привести не получится - они зависят от размера системы, частоты релизов и устройства сборки, и переносить их с проекта на проект бессмысленно. Но статьи расходов именно эти три, и разговор с руководством в них ведётся предметнее, чем в абстрактном «качестве кода».
Четвёртое следствие: возвращение к тесту
Среди четырёх ограничений, перечисленных в начале статьи, было одно, к которому стоит вернуться отдельно: модуль нельзя проверить без базы данных. Посмотрим, что с ним стало.
class InMemoryOrderRepository : OrderRepository {
    private val storage = mutableMapOf<OrderId, Order>()
    override fun findById(id: OrderId) = storage[id]
    override fun save(order: Order) { storage[order.id] = order }
}

@Test
fun `заказ с пустой корзиной не принимается`() {
    val useCase = PlaceOrder(InMemoryOrderRepository())

    val result = useCase.execute(OrderDraft(items = emptyList()))

    assertTrue(result.isFailure)
}
Ни базы данных, ни контейнера, ни сетевых вызовов. Хранилище подменено словарём в памяти, и бизнес-логика подмены не заметила: обе реализации одинаково выполняют обещание. Тест отрабатывает быстро и падает тогда, когда сломана именно бизнес-логика.
Заметим, что ради тестов ничего не делалось. Зависимости разворачивались ради независимой сборки и сменных модулей, а тестируемость появилась следом. В предыдущей части мы приходили к этому с другой стороны и сформулировали так: если что-то трудно протестировать, проблема почти никогда не в тестах, проблема в структуре. Там же отмечалось, что скрытые зависимости стоит превращать в явные параметры. Интерфейс в модуле ordering - это та же мысль, применённая не к одной функции, а к границе между модулями.
Где этого делать не надо
Инвертировать все зависимости подряд незачем, и статья была бы неполной без разговора о цене.
Каждый интерфейс - дополнительная сущность, лишний уровень косвенности и чуть большее усилие при чтении кода. Переходя по вызову, читатель попадает не в реализацию, а в объявление, и выясняет отдельно, кто за этим объявлением стоит. В большой системе такие прыжки накапливаются.
Платить эту цену стоит там, где проходит граница: между бизнес-логикой и внешним миром. База данных, сторонние службы, файловая система, доставка сообщений, пользовательский интерфейс - всё неподконтрольное системе и способное смениться по причинам, к бизнес-логике отношения не имеющим.
Внутри одного смыслового слоя интерфейсы чаще мешают. Класс, считающий налог, и класс, применяющий скидку, живут в одном модуле, меняются по одним и тем же причинам, выкатываются вместе. Интерфейс между ними не даёт ничего: он существует ради того, чтобы одну сторону можно было подменить независимо от другой, а подменять пока нечего - второй реализации расчёта налога в системе нет.
Возражение напрашивается само: а вдруг она появится? Налоговые правила отличаются от страны к стране, и вторая схема расчёта - вещь вполне вероятная. Если она появится, критерий сработает в её пользу: как только вторую реализацию можно будет назвать, интерфейс станет оправдан. Утверждение здесь не в том, что он не понадобится никогда, а в том, что заводить его под предположение - значит платить за дополнительный уровень косвенности, ничего пока не получая взамен.
Практический ориентир: инвертируйте зависимость там, где вы можете внятно назвать второй возможный вариант реализации - уже существующий или тот, к которому система явно идёт. Для хранилища он есть почти всегда: хотя бы версия в памяти, которую мы написали для теста. Если же на вопрос «а какая здесь может быть вторая реализация?» ответа не находится, интерфейс, скорее всего, преждевременен. Появится второй вариант позже - интерфейс можно будет извлечь, и основную часть этой работы сделает среда разработки.
Здесь же пригождается приём, упомянутый в разделе об инкапсуляции. Классы внутри модуля-плагина помечают как internal: наружу торчит только реализуемый интерфейс, остальное соседям недоступно даже при желании. Граница, проведённая направлением зависимостей, подкрепляется границей видимости - и две меры вместе работают надёжнее каждой по отдельности.
Заключение
Соберём сказанное.
Статья началась с четырёх ограничений, в которые упирается модуль бизнес-логики, сославшийся на базу данных: его не собрать отдельно, не проверить без базы, трудно передать другой команде, а замена хранилища задевает правила расчёта. Источником всех четырёх оказалось избыточное знание: модуль знал об устройстве хранилища больше, чем требовала его собственная работа.
Из трёх понятий, которыми принято определять объектно-ориентированное программирование, два к решению этой задачи не ведут. Инкапсуляция появилась раньше объектно-ориентированных языков и в них ослабла: в C структура скрывалась целиком, в C++ поля переехали в заголовок, в Java и Kotlin приватность держится на обещании компилятора. Рабочая граница сегодня проходит по модулю сборки, а не по ключевому слову private. Наследование тоже существовало до появления языков - в виде ручного приёма с совпадающей раскладкой полей. Языки сделали его безопасным, но связь оно создаёт жёсткую, затрагивающую внутреннее устройство предка, и композиция нередко оказывается удачнее.
Задачу решает третье понятие. Полиморфизм был возможен и раньше - через таблицы указателей на функции, как в драйверах UNIX, - но обходился слишком дорого в ошибках, чтобы применять его повседневно. Языки сделали его дешёвым и проверяемым, и этим открыли приём, недоступный прежде.
Приём состоит в том, что интерфейс объявляется в модуле-потребителе, а реализация ссылается на него снизу вверх. Поток управления при этом остаётся прежним, а зависимость исходного кода разворачивается против него. Для архитектора объектно-ориентированное программирование означает прежде всего эту возможность: направление каждой связи в тексте программы задаётся отдельно, независимо от того, кто кого вызывает.
Из такого контроля вырастает архитектура сменных модулей, где база данных и пользовательский интерфейс становятся плагинами к бизнес-правилам. Выигрыш распределяется по трём статьям расходов: время сборки, объём проверок при релизе, затраты на согласование между командами. Тестируемость при этом получается побочным следствием, а не отдельной работой.
Две оговорки, без которых приём превращается в ритуал. Первая: интерфейс стоит объявлять там, где им пользуются, а не там, где его реализуют, - проверяется мысленным удалением модуля с реализацией. Вторая: инвертировать всё подряд не нужно, интерфейс оправдан на границе, за которой лежит внешний мир или реальная альтернатива.
Спасибо, что дочитали до конца.
В следующей части мы разберём третью, последнюю парадигму - функциональное программирование. Поговорим о том, почему ограничение на присваивание оказалось не причудой математиков, что такое функциональное ядро в императивной оболочке и почему хранение событий вместо текущего состояния меняет взгляд на устройство данных.
Следите за продолжением.