Введение
В предыдущей части мы говорили о том, что каждая парадигма программирования не расширяет возможности разработчика, а сознательно их ограничивает. Структурное программирование забрало у нас неограниченные переходы, а взамен дало возможность разбирать программу на части и проверять каждую отдельно.
Теперь очередь второй парадигмы. И здесь нас ждёт неожиданность.
Про объектно-ориентированное программирование написано очень много. Его преподают в университетах, о нём спрашивают на собеседованиях, им объясняют устройство почти каждого корпоративного приложения. Казалось бы, уж тут всё давно ясно.
Но попробуйте задать вопрос: что такое объектно-ориентированное программирование? Не как им пользоваться, а что это по существу. Чаще всего в ответ звучит одна из двух формулировок, и обе при ближайшем рассмотрении рассыпаются.
Посмотрим, что остаётся, когда привычные формулировки не выдерживают проверки, и почему остаток оказывается сильнейшим инструментом в руках архитектора.
Почему привычные определения не работают
«Это объединение данных и функций в одном месте.»
Формулировка звучит солидно, но ничего не определяет. Она подразумевает, что вызов o.f() чем-то отличается от вызова f(o). А это не так: в первом случае объект передаётся неявно, во втором явно, и на этом разница в записи заканчивается. Программисты объединяли данные с работающими над ними функциями задолго до появления первых объектно-ориентированных языков - передавали структуру первым аргументом. Возразят: вызов метода ведь ещё и выбирает реализацию по фактическому типу объекта. Верно, но этим мы обязаны полиморфизму, а не объединению данных с функциями, и к полиморфизму мы ещё вернёмся. Само по себе соседство полей и методов новой парадигмы не создаёт.
«Это способ моделировать реальный мир.»
Второй ответ ещё более уклончив. Что означает «моделировать реальный мир» применительно к банковской транзакции, HTTP-запросу или индексу базы данных? И главное - зачем? Предполагается, видимо, что близость к реальности делает код понятнее. Но такое утверждение не проверяется и, что хуже, не подсказывает ни одного конкретного решения.
Для тех, кто только начинает: речь не о том, что объектно-ориентированный подход бесполезен. Речь о том, что от определения требуется работать как инструмент. Хорошее определение отвечает на вопрос «что я стану делать по-другому, узнав это?». Оба ответа выше на него не отвечают.
Остаётся третий, самый распространённый вариант: объектно-ориентированное программирование - это инкапсуляция, наследование и полиморфизм. Проверим каждое слово отдельно.
Инкапсуляция: чужая заслуга
Инкапсуляция очерчивает границу вокруг группы данных и функций: снаружи видны некоторые функции, данные скрыты. Объектно-ориентированные языки дают для этого удобный синтаксис - приватные поля, публичные методы.
Беда в том, что это не их изобретение. Хуже того, они эту возможность ослабили.
Посмотрите, как инкапсуляция выглядит в языке C. Заголовочный файл объявляет только то, что доступно снаружи:
/* point.h - это всё, что видит пользователь */
struct Point;
struct Point* makePoint(double x, double y);
double distance(struct Point* p1, struct Point* p2);
Реализация живёт отдельно и наружу не выходит:
/* point.c */
#include "point.h"
#include <stdlib.h>
#include <math.h>

struct Point {
    double x, y;
};

struct Point* makePoint(double x, double y) {
    struct Point* p = malloc(sizeof(struct Point));
    p->x = x;
    p->y = y;
    return p;
}

double distance(struct Point* p1, struct Point* p2) {
    double dx = p1->x - p2->x;
    double dy = p1->y - p2->y;
    return sqrt(dx*dx + dy*dy);
}
Этот пример реализован на языке C намеренно: вся его суть - в физическом разделении объявления и реализации на два файла. В Java, C# и Kotlin такого разделения нет.
Обратите внимание на деталь. Пользователь point.h не только не обратится к полям x и y - он вообще не знает об их существовании. Структура объявлена, но не определена. Добавьте в неё третье поле, переименуйте существующие, поменяйте типы: ни один вызывающий модуль не потребует перекомпиляции.
Теперь то же самое на C++, где появились классы:
// point.h
class Point {
public:
    Point(double x, double y);
    double distance(const Point& p) const;
private:
    double x;
    double y;
};
Компилятор не даст обратиться к x и y напрямую. Но они теперь написаны в заголовочном файле, на виду у всех, кто его подключает. Переименуйте поле - и зависимые файлы придётся пересобрать. Строгая инкапсуляция, что была в C, разрушена, а ключевые слова public и private лишь частично прикрыли последствия.
Справедливости ради: в C++ скрытие полей восстанавливают приёмом pimpl - в заголовке остаётся только объявление вложенной структуры и указатель на неё, а поля уезжают в файл реализации. Приём рабочий, но платить за него приходится дополнительным выделением памяти и потерей встраивания. Инкапсуляцию в C++ приходится выстраивать осознанно, тогда как в C она получалась сама собой.
Java, C# и Kotlin пошли дальше и отменили разделение на объявление и реализацию вовсе. Приватное поле в Kotlin защищено одним обещанием компилятора:
class Point(private val x: Double, private val y: Double) {
    fun distanceTo(other: Point): Double {
        val dx = x - other.x
        val dy = y - other.y
        return sqrt(dx * dx + dy * dy)
    }
}
Обещание компилятор держит. Но на JVM вызов setAccessible(true) снимает запрет за три строки, а о самом существовании полей знает каждый, кто открыл файл.
Вывод выходит неудобным для привычной картины мира: объектно-ориентированные языки инкапсуляцию не улучшили, а ослабили. Держится она в итоге не на языке, а на дисциплине команды - на том, что никто не полезет внутрь чужого модуля обходным путём.
Что из этого следует на практике
Было бы ошибкой заключить, что инкапсуляция не нужна. Нужна, только искать её стоит не на уровне класса, а на уровне модуля.
Настоящая граница проходит по единице сборки, а не по ключевому слову внутри класса. В Kotlin за это отвечает модификатор internal: он ограничивает видимость модулем - так документация Kotlin называет набор файлов, компилируемых вместе: модуль IntelliJ IDEA, проект Maven, исходный набор Gradle. Тестовый исходный набор при этом видит internal-объявления основного. Вот такая граница уже работает: соседний модуль не сошлётся на скрытый класс, потому что компилятор запретит.
В Java той же цели служат два механизма. Пакетная видимость - отсутствие модификатора вовсе - закрывает класс от всех, кто лежит в другом пакете. А начиная с девятой версии есть система модулей: пакет, не перечисленный в exports файла module-info.java, недоступен снаружи ни при компиляции, ни во время выполнения.
// модуль billing, файл InvoiceCalculator.kt

// Видно всем, кто подключил модуль billing
interface InvoiceCalculator {
    fun calculate(order: Order): Invoice
}

// Видно только внутри модуля billing
internal class DefaultInvoiceCalculator(
    private val taxPolicy: TaxPolicy
) : InvoiceCalculator {
    override fun calculate(order: Order): Invoice { /* ... */ }
}
Оговорка, о которой умалчивают учебники: запрет живёт на уровне компилятора Kotlin. Документация по совместимости с Java говорит об этом прямо: internal-объявления становятся в Java публичными. Имена internal-членов компилятор искажает, чтобы ими не воспользовались по случайности, но имена публичных членов internal-класса не искажаются и остаются вызываемыми из Java. Команде, пишущей целиком на Kotlin, этой границы хватает. В смешанном проекте её придётся подпирать разделением артефактов сборки.
Разница между двумя уровнями защиты принципиальна. Приватное поле говорит «пожалуйста, не трогайте». Отдельный модуль со скрытыми классами говорит «вы не дотянетесь, даже если захотите». Первое - соглашение, второе - ограничение. В прошлой части мы уже видели, что архитектура строится на ограничениях.
Практический ориентир: если все классы проекта публичны и лежат в одном модуле, инкапсуляции у вас нет - независимо от того, сколько полей помечено как private. Это не катастрофа, но и защитой это считать не стоит.
Наследование: удобство, а не открытие
Со вторым понятием дело обстоит чуть лучше, хотя ненамного.
Наследование по сути - повторное объявление набора полей и функций в ограниченной области видимости. Такое делали и до появления объектно-ориентированных языков, причём сознательно. Приём такой: объявить структуру, первые поля которой в точности повторяют поля другой структуры, в том же порядке.
/* namedPoint.h */
struct NamedPoint {
    double x, y;      /* те же два поля, что и в Point, в том же порядке */
    char* name;
};
Раскладка полей в памяти совпадает, поэтому указатель на NamedPoint приводят к указателю на Point и передают в функцию, не подозревающую о существовании NamedPoint:
struct NamedPoint* origin = makeNamedPoint(0.0, 0.0, "origin");
struct NamedPoint* corner = makeNamedPoint(1.0, 1.0, "upperRight");

printf("distance=%f\n",
       distance((struct Point*) origin, (struct Point*) corner));
Работает: программа печатает distance=1.414214. Примерно так же компиляторы C++ реализуют одиночное наследование - подобъект базового класса размещается в начале производного, и приведение указателя вверх по иерархии не меняет адрес. Оговорка: раскладку объекта диктует не стандарт языка, а соглашение конкретной платформы, и как только у класса появляются виртуальные функции, в начало объекта встаёт указатель на таблицу методов, так что совпадения с простой структурой уже не выйдет.
Но полноценным наследованием это не назвать. Приведение типа пишется руками, компилятор ничего не проверяет, а одна перестановка полей в структуре превращает программу в источник неуловимых ошибок. Множественное наследование таким приёмом не изобразить: в начале структуры помещается только один чужой набор полей.
Справедливый итог: объектно-ориентированные языки сделали приём безопасным и удобным, превратив ручной трюк в языковую конструкцию. Улучшение, а не изобретение.
На современном языке то же самое выглядит так:
import kotlin.math.sqrt

open class Point(val x: Double, val y: Double)

class NamedPoint(x: Double, y: Double, val name: String) : Point(x, y)

fun distance(a: Point, b: Point): Double {
    val dx = a.x - b.x
    val dy = a.y - b.y
    return sqrt(dx * dx + dy * dy)
}

fun main() {
    val origin = NamedPoint(0.0, 0.0, "origin")
    val corner = NamedPoint(1.0, 1.0, "upperRight")
    println("distance=${distance(origin, corner)}")  // приведение не требуется
}
Почему Kotlin закрывает классы по умолчанию
Здесь полезно присмотреться к одному решению авторов языка. В Kotlin класс по умолчанию закрыт для наследования: чтобы от него унаследоваться, его помечают как open. Обратите внимание на предыдущий пример - без open перед class Point он не скомпилируется.
Это не мелочь синтаксиса, а архитектурная позиция. Наследование создаёт самую жёсткую связь между двумя классами. Наследник зависит не только от публичного контракта предка, но и от его внутреннего устройства. Правка в базовом классе ломает десяток потомков, которых автор правки в глаза не видел.
Отсюда правило, сформулированное ещё в 1994 году в книге «Приёмы объектно-ориентированного проектирования» Гаммы, Хелма, Джонсона и Влиссидеса: предпочитайте композицию объектов наследованию классов. Там же сказано и то, с чего мы начали этот раздел: наследование нарушает инкапсуляцию. Наследование оправдано там, где вы строите иерархию типов и любой потомок подставляется вместо предка без сюрпризов. В остальных случаях передайте нужный объект внутрь и вызывайте его методы.
// Сомнительно: отчёт наследуется ради пары чужих методов
open class ReportBase { /* ... */ }
class PdfReport : ReportBase() { /* ... */ }

// Лучше: отчёт получает то, что ему требуется, и ничего не наследует
class PdfReport(private val renderer: DocumentRenderer) { /* ... */ }
Во втором варианте PdfReport не знает внутреннего устройства renderer и переживёт любые изменения внутри него. В первом он связан с ReportBase намертво.
Счёт пока не впечатляет: за инкапсуляцию объектно-ориентированному подходу засчитать нечего, за наследование набегает половина очка. Остаётся третье понятие, и с ним всё обстоит иначе.
Полиморфизм: здесь начинается архитектура
Начнём с того же вопроса: существовал ли полиморфизм до объектно-ориентированных языков? Разумеется. Посмотрите на программу копирования - она переливает данные с одного устройства на другое:
#include <stdio.h>

void copy(void) {
    int c;
    while ((c = getchar()) != EOF)
        putchar(c);
}
Функция getchar() читает символы из стандартного ввода. Но что такое стандартный ввод? Клавиатура? Файл? Сетевое соединение? Программа этого не знает и знать не должна. То же с putchar(). Обе функции ведут себя полиморфно: результат зависит от устройства на другом конце.
Как это устроено внутри? Ядро UNIX хранило таблицу драйверов, и каждая запись в ней была набором указателей на функции с заранее оговорёнными сигнатурами. В шестой и седьмой редакциях UNIX структура символьного устройства cdevsw содержала пять таких указателей: открыть, закрыть, прочитать, записать и управлять устройством - последний назывался d_sgtty и позже превратился в привычный нам ioctl. У блочных устройств была своя, более короткая таблица bdevsw: открыть, закрыть и передать запрос дисковой подсистеме.
Названия и состав функций от редакции к редакции менялись. Неизменным оставалось главное: фиксированный набор операций с фиксированными сигнатурами, одинаковый для всех драйверов. Это и есть интерфейс, только выраженный средствами языка C.
Вот упрощённая версия такой таблицы:
/* Упрощение: в настоящем ядре структура называлась cdevsw,
   а поля - d_open, d_close, d_read, d_write, d_sgtty */
struct Device {
    void (*open)(char* name, int mode);
    void (*close)(void);
    int  (*read)(void);
    void (*write)(int c);
    void (*control)(int request, long arg);
};
Драйвер консоли заполняет такую структуру указателями на свои реализации:
static void consoleOpen(char* name, int mode) { /* ... */ }
static void consoleClose(void) { /* ... */ }
static int  consoleRead(void) { int c; /* ... */ return c; }
static void consoleWrite(int c) { /* ... */ }
static void consoleControl(int request, long arg) { /* ... */ }

struct Device console = { consoleOpen, consoleClose, consoleRead,
                          consoleWrite, consoleControl };
И тогда чтение символа сводится к одной строке - вызову через указатель:
extern struct Device* STDIN;

int readChar(void) {
    return STDIN->read();
}
Настоящий getchar() из стандартной библиотеки устроен сложнее: он работает с буфером внутри структуры FILE и обращается к ядру только когда буфер опустел. Но на дне этой цепочки лежит ровно тот же приём - вызов через указатель, выбранный во время выполнения.
Полиморфизм - это вызов функции по адресу, известному лишь во время выполнения. Больше ничего. Когда вы вызываете виртуальный метод в Kotlin, Java или C#, работает та же модель: обращение к таблице методов, соответствующей фактическому классу объекта. Конечно, по сравнению с C, на JVM картина сложнее - виртуальная машина нередко определяет фактический тип заранее и встраивает вызов, - но смысловая схема именно такая.
На современном языке тот же замысел записывается так:
const val EOF = -1

interface CharDevice {
    fun read(): Int        // код символа, либо EOF
    fun write(code: Int)
}

fun copy(source: CharDevice, target: CharDevice) {
    while (true) {
        val code = source.read()
        if (code == EOF) break
        target.write(code)
    }
}
Разница между двумя записями не в возможностях, а в цене ошибки.
Указатели на функции опасны по своей природе. Их легко забыть инициализировать. Легко перепутать порядок полей в структуре. Легко вызвать в обход оговорённых правил. Стоит одному человеку в команде нарушить любое из этих негласных соглашений - и вы получите ошибку, которую будут искать неделю, потому что падать программа станет совсем не там, где сделана ошибка.
Объектно-ориентированные языки избавили нас от необходимости держать соглашения в голове. Компилятор сам построит таблицу, сам подставит адрес, сам сверит сигнатуры. Полиморфизм подешевел настолько, что его применяют повсюду, а не в двух-трёх важнейших местах программы.
Вот в этом смысле объектно-ориентированное программирование и накладывает ограничение на косвенную передачу управления: оно забирает свободное обращение с указателями на функции и взамен выдаёт дисциплинированный, проверяемый компилятором механизм.
Архитектура со сменными модулями
Вернёмся к программе копирования и спросим: что придётся в ней изменить, если на входе появится сканер рукописного текста, а на выходе синтезатор речи?
Ответ: ничего. Программу даже не придётся пересобирать.
Её исходный код не содержит ни одной ссылки на код драйверов. Пока новое устройство предоставляет оговорённый набор функций, программа с ним работает. Устройства ввода-вывода превратились в подключаемые модули - плагины.
Идея родилась не из любви к красивым абстракциям, а из вполне практической боли. В пятидесятых годах программы писались под конкретное устройство: прочитать колоду перфокарт, пробить новую колоду с результатом. Потом заказчики понесли данные на магнитной ленте, и выяснилось, что программу придётся переписывать целиком - при том что сама логика обработки не изменилась ни на йоту. Независимость от устройства оказалась не роскошью, а условием выживания программы.
Вспомните пример из первой части: система формирует отчёты в PDF, бизнес просит добавить выгрузку в Excel. Это та же задача, только сорок лет спустя. Если формат вывода сделан плагином - работы на день. Если логика отчёта срослась с генерацией PDF - работы на месяц.
// Бизнес-логике всё равно, во что превратится отчёт
interface ReportRenderer {
    fun render(report: Report): ByteArray
}

class PdfRenderer : ReportRenderer {
    override fun render(report: Report): ByteArray = TODO()
}

// Новый формат. В бизнес-логике не меняется ни строки
class ExcelRenderer : ReportRenderer {
    override fun render(report: Report): ByteArray = TODO()
}
Архитектуру плагинов придумали и реализовали в операционных системах рано. А вот в прикладных программах она долго не приживалась - именно из-за опасности указателей на функции. Объектно-ориентированная парадигма это препятствие убрала.
Инверсия зависимости: власть над направлением связей
Здесь мы подходим к сути. Чтобы её увидеть, разделим два понятия, которые в обычном разговоре сливаются.
Поток управления - кто кого вызывает во время работы программы.
Зависимость исходного кода - кто на кого ссылается в тексте программы: import, using, #include.
До появления надёжного полиморфизма эти две вещи были связаны намертво. Главная функция вызывает функции верхнего уровня, те - функции среднего уровня, те - нижнего. А чтобы вызвать функцию, модуль обязан на неё сослаться. Обе стрелки смотрят в одну сторону.
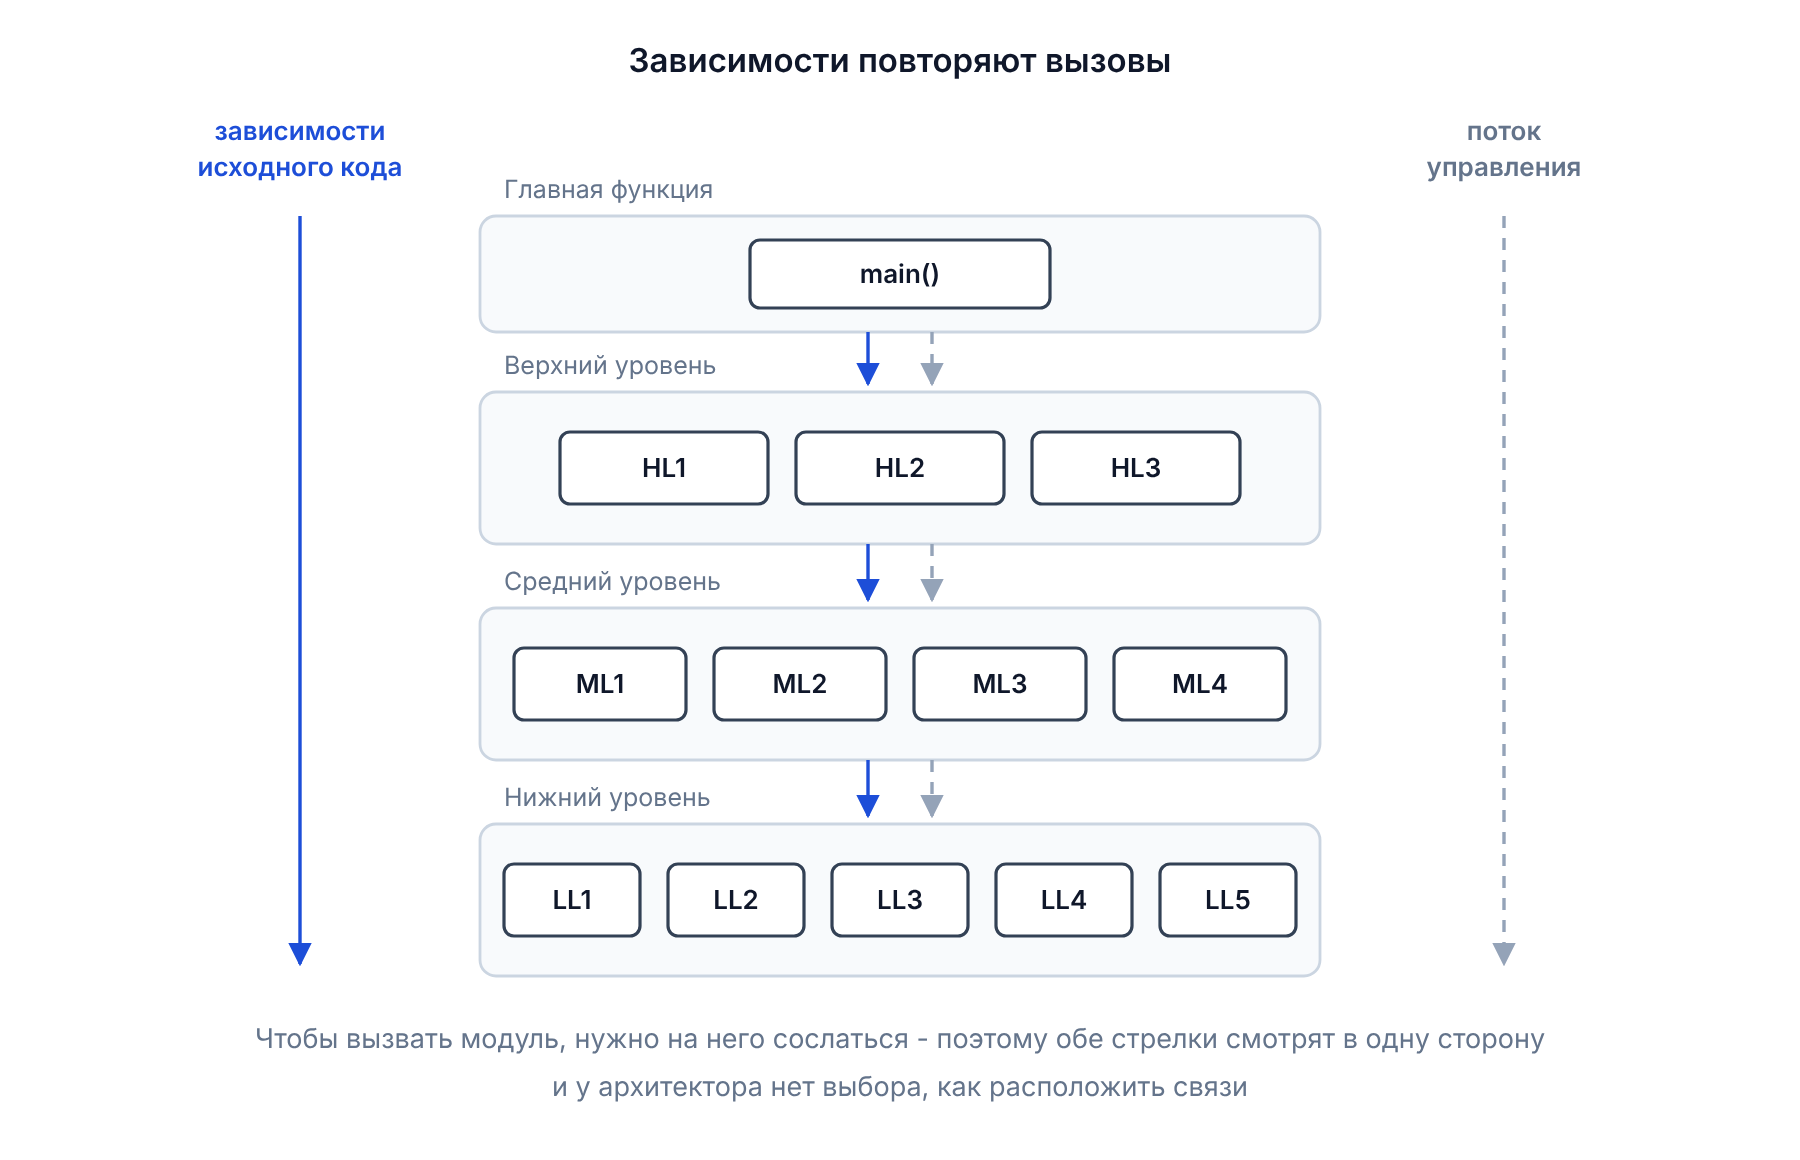
Рисунок 1. В классической многоуровневой структуре зависимость исходного кода повторяет поток управления. У архитектора нет выбора: направление связей задано тем, кто кого вызывает.
Ограничение это стоит осознать до конца. Модуль с бизнес-логикой обязан ссылаться на модуль работы с базой данных - потому лишь, что он его вызывает. Правила расчёта скидок оказываются привязаны к драйверу PostgreSQL. Картина типичная: модуль расчёта тарифов импортирует класс из пакета работы с хранилищем, и смена хранилища превращается в многомесячный проект, хотя сами тарифы остаются прежними.
Полиморфизм эту связь разрывает.
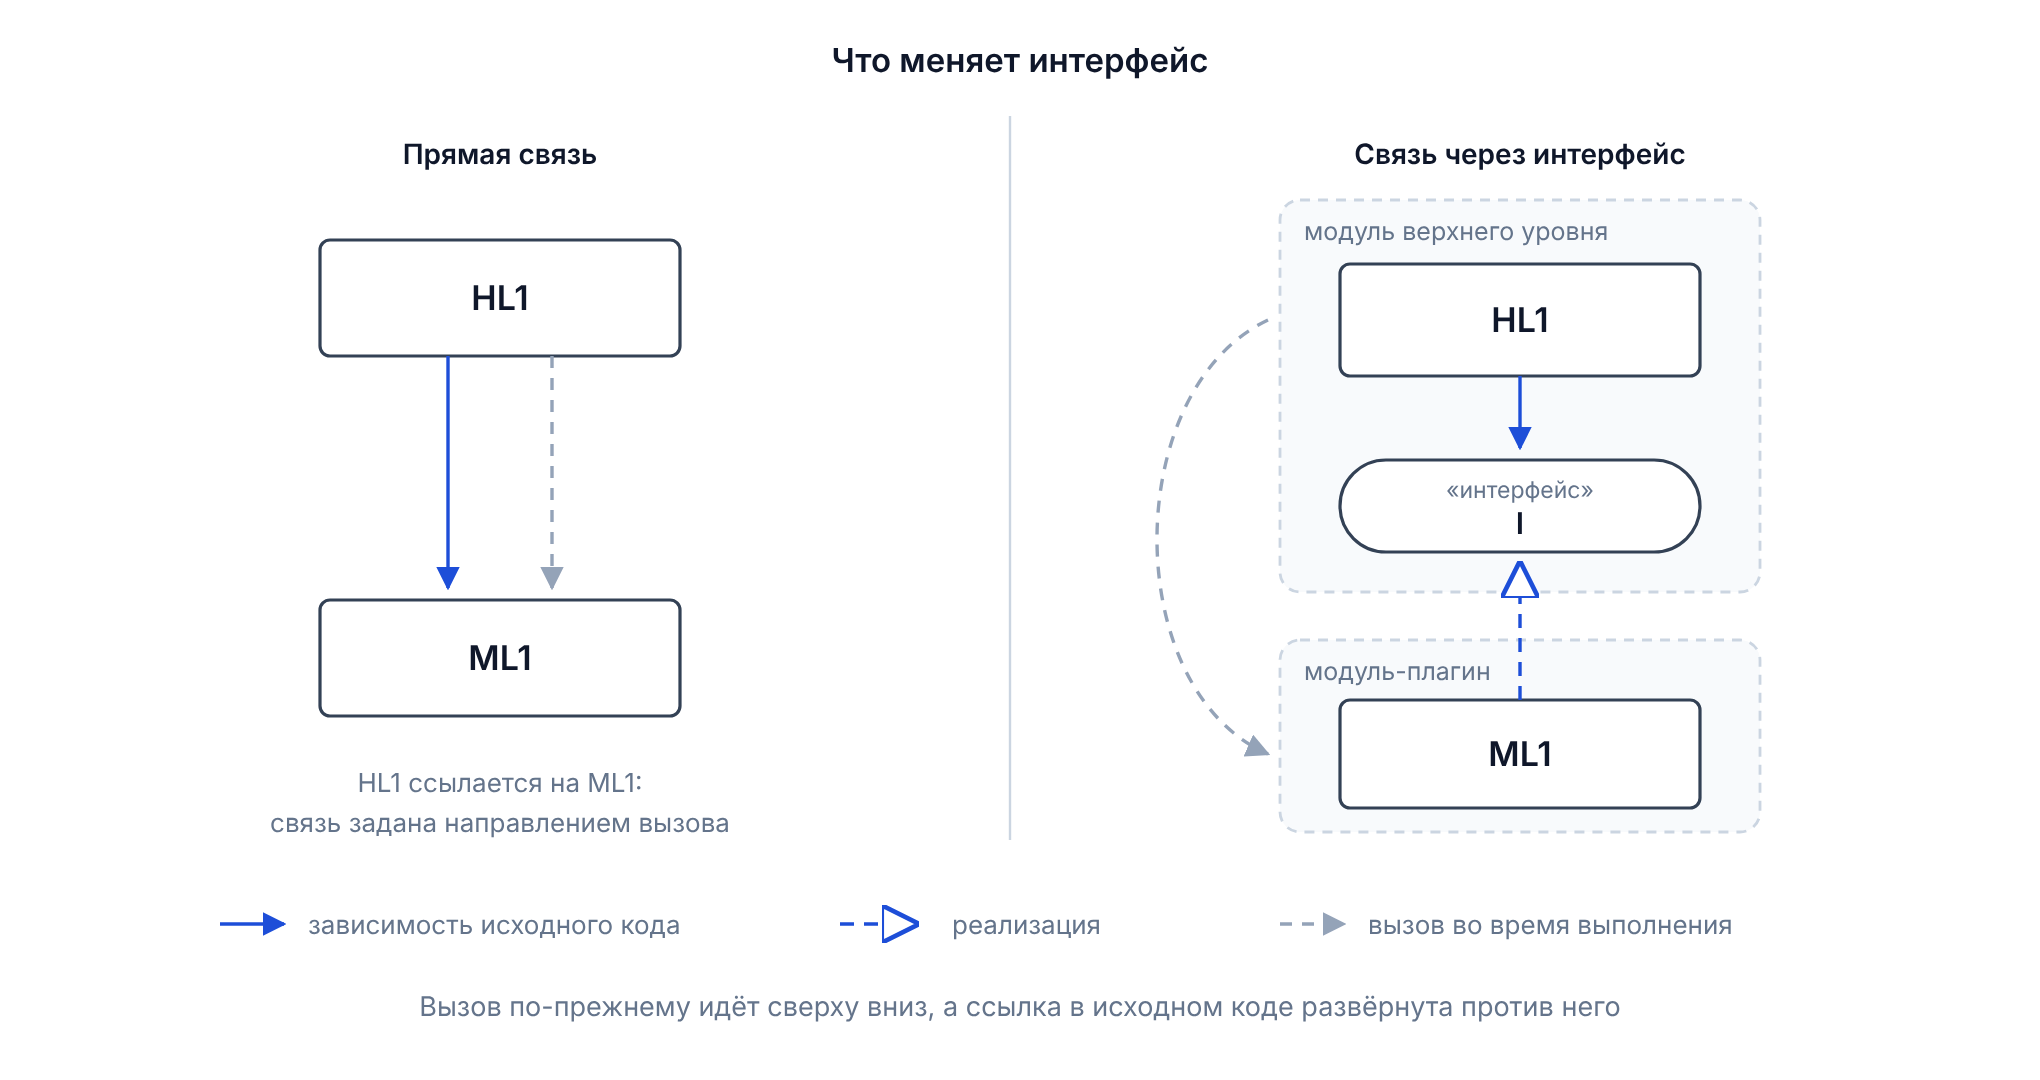
Рисунок 2. Слева прямая связь: ссылка в исходном коде повторяет вызов. Справа та же пара модулей через интерфейс. Поток управления по-прежнему идёт от HL1 к ML1, а зависимость исходного кода от ML1 направлена вверх, к интерфейсу, то есть против потока управления.
Разберём правую половину. Модуль верхнего уровня HL1 вызывает метод F(). В тексте программы он ссылается только на интерфейс I, лежащий здесь же, в его собственном модуле. Модуль ML1 реализует этот интерфейс, а значит, ссылается на него снизу вверх, пересекая границу модуля.
Во время выполнения никакого интерфейса не существует: HL1 просто вызывает код внутри ML1, как и раньше. Поток управления не изменился. Изменилось направление зависимости в исходном коде - теперь оно противоположно направлению вызова.
Эффект называется инверсией зависимости, и последствия у него шире, чем кажется на первый взгляд.
Любую зависимость в исходном коде разворачивают, вставив между модулями интерфейс. Любую. Вернитесь мысленно к первой схеме и представьте, что каждая стрелка смотрит туда, куда вам требуется, независимо от того, кто кого вызывает.
Архитектор получает полный контроль над структурой связей. Не над тем, что происходит во время выполнения - это диктует задача, - а над тем, как устроен текст программы. А структура текста, как мы говорили в первой части, и определяет стоимость будущих изменений.
Вот как это выглядит в коде:
// ===== Модуль ordering: бизнес-правила =====
// Ни одной ссылки на базу данных или веб-фреймворк

interface OrderRepository {
    fun findById(id: OrderId): Order?
    fun save(order: Order)
}

interface NotificationSender {
    fun orderConfirmed(order: Order)
}

class PlaceOrder(
    private val orders: OrderRepository,
    private val notifications: NotificationSender
) {
    fun execute(draft: OrderDraft): Result<Order> {
        val order = Order.from(draft).getOrElse { return Result.failure(it) }
        orders.save(order)
        notifications.orderConfirmed(order)
        return Result.success(order)
    }
}
// ===== Модуль persistence: деталь реализации =====
// Ссылается на модуль ordering. Обратной ссылки нет

internal class PostgresOrderRepository(
    private val db: Database
) : OrderRepository {

    override fun findById(id: OrderId): Order? =
        db.query("SELECT ... WHERE id = ?", id.value)?.toDomain()

    override fun save(order: Order) {
        db.upsert(order.toRow())
    }
}
Обратите внимание на направление. Модуль persistence знает про модуль ordering, потому что реализует его интерфейс. Модуль ordering про persistence не знает ничего. При этом во время выполнения вызов идёт в обратную сторону, из бизнес-логики в базу.
Самая частая ошибка
А теперь то, на чём ломается большинство попыток применить инверсию зависимости.
Интерфейс принадлежит модулю, который его использует, а не модулю, который его реализует.
Объявите OrderRepository в модуле persistence рядом с реализацией - и вы не инвертировали ничего. Бизнес-логике по-прежнему придётся импортировать тип из модуля базы данных, теперь уже интерфейс вместо класса. Стрелка осталась на месте, а сущностей стало больше.
Проверка занимает минуту. Удалите модуль persistence из сборки целиком и попробуйте скомпилировать ordering. Собралось - инверсия настоящая. Не собралось - это декорация.
Из того же рассуждения следует, как формулировать интерфейс. Он описывает потребность вызывающей стороны, а не возможности реализации. Интерфейс, слово в слово повторяющий публичные методы одного конкретного класса, выдаёт автора, писавшего его от реализации. Пользы от такого интерфейса нет: он меняется ровно тогда же, когда меняется класс.
// Признак проблемы: интерфейс описывает устройство хранилища
interface OrderRepository {
    fun executeQuery(sql: String): ResultSet
    fun beginTransaction(): Transaction
}

// Так лучше: интерфейс описывает потребность бизнес-логики
interface OrderRepository {
    fun findById(id: OrderId): Order?
    fun save(order: Order)
}
Второй вариант переживёт переезд с PostgreSQL куда угодно. Первый развалится при первой же смене хранилища, потому что в него уже протекли понятия конкретной технологии: строка запроса и транзакция.
Где проводить границы
Ещё одно уточнение, без которого совет легко довести до абсурда. Инвертировать все зависимости подряд незачем.
Каждый интерфейс - лишняя сущность, дополнительный уровень косвенности и чуть большее усилие при чтении кода. Платить эту цену имеет смысл там, где граница и проходит: между вашей бизнес-логикой и внешним миром. База данных, сторонние службы, файловая система, доставка сообщений, пользовательский интерфейс.
Внутри одного смыслового слоя интерфейсы только мешают. Класс, считающий налог, и класс, применяющий скидку, живут в одном модуле, меняются по одним и тем же причинам и обходятся прямыми вызовами.
Ориентир простой: инвертируйте зависимость там, где вы внятно назовёте второй возможный вариант реализации. Нет такого варианта и не предвидится - значит, интерфейс пока преждевременен.
Что это даёт на уровне системы
Соберём всё вместе. Получив контроль над направлением зависимостей, архитектор выстраивает систему так, чтобы и пользовательский интерфейс, и база данных зависели от бизнес-правил, а не наоборот.
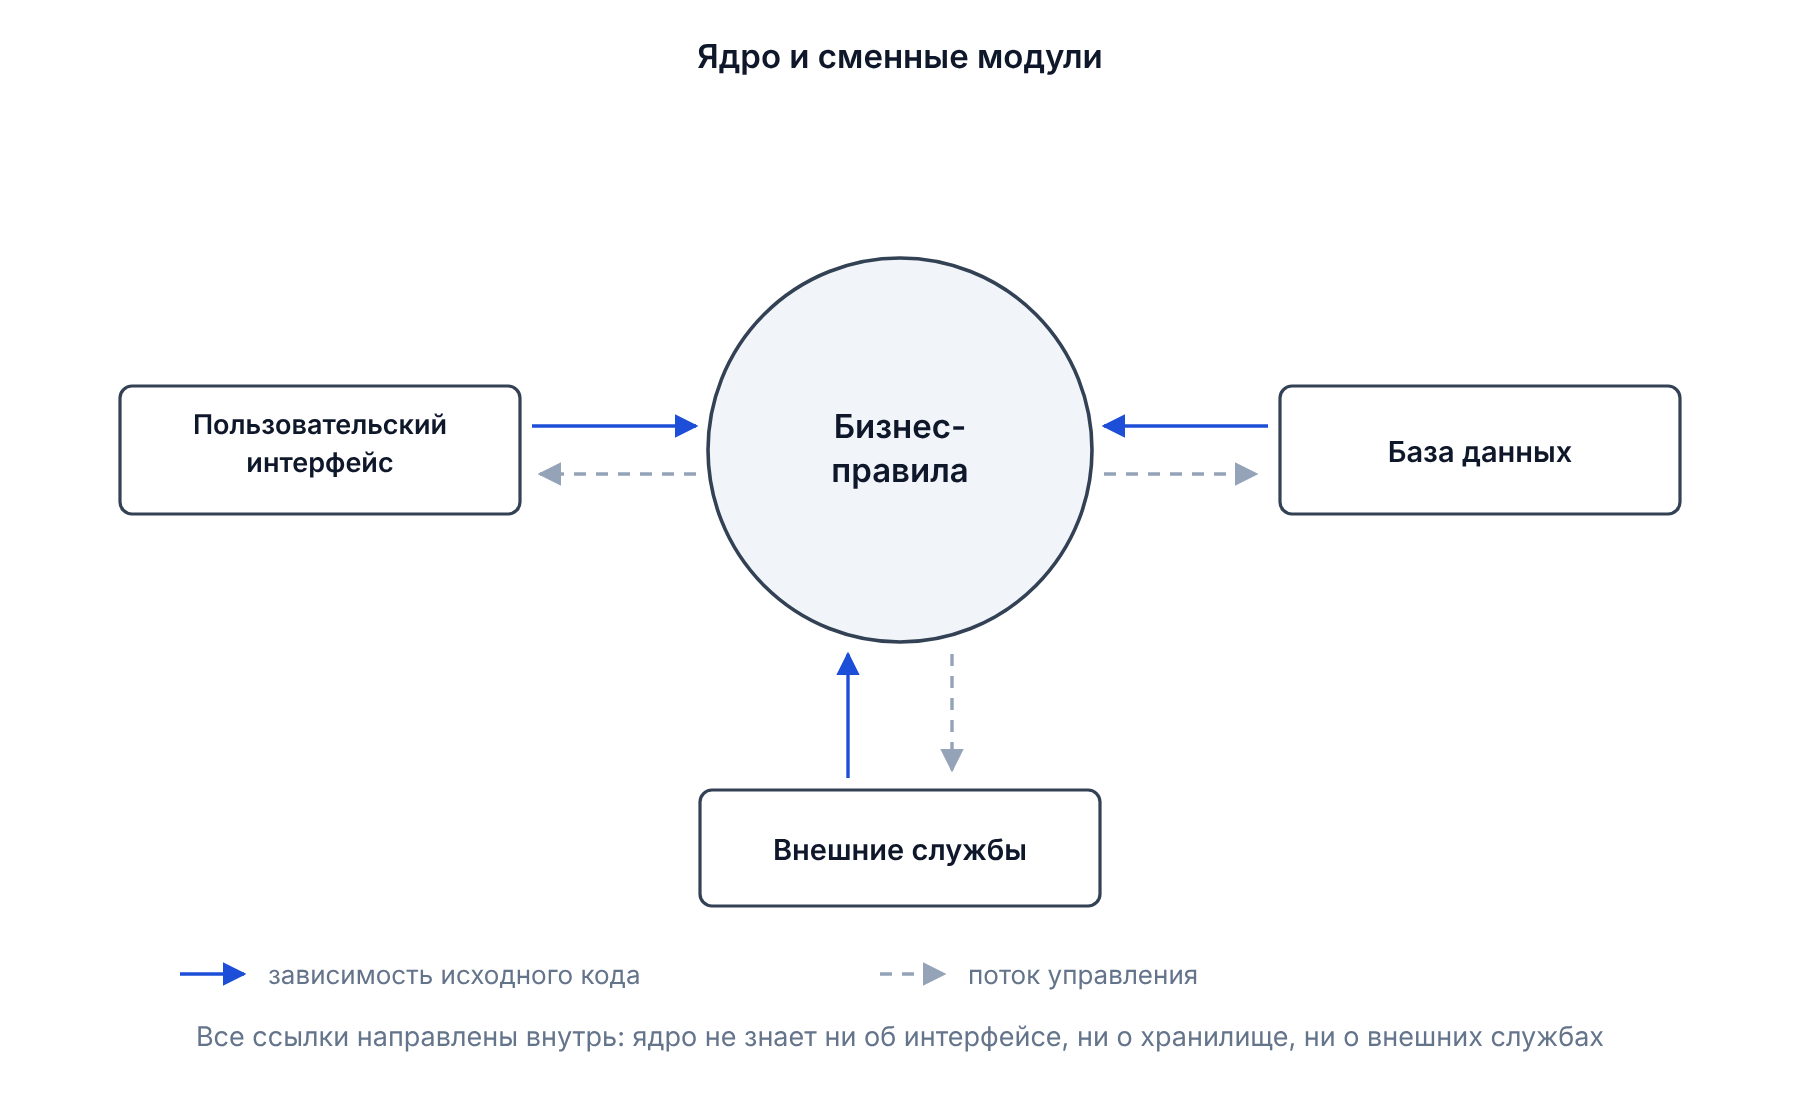
Рисунок 3. Все стрелки зависимости направлены внутрь, к бизнес-правилам, хотя поток управления идёт в обе стороны. Интерфейс, хранилище и внешние службы становятся сменными модулями вокруг неизменного ядра.
В коде бизнес-правил нет ни одного упоминания ни об интерфейсе, ни о базе данных, ни о платёжном шлюзе. Они стали плагинами - подключаемыми модулями, замена которых ядра не касается.
Отсюда вытекают три следствия. Каждое сокращает свою статью расходов - те самые усилия на изменения, которые в первой части мы назвали единственным честным мерилом архитектуры.
Независимость сборки. Бизнес-правила, интерфейс и работа с данными собираются в три отдельных модуля с теми же зависимостями, что и в исходном коде. Модуль бизнес-правил не зависит ни от одного из остальных.
Сокращается здесь рабочее время. Правка задевает один модуль - пересобирается один модуль, и цикл «изменил, собрал, проверил» укорачивается. Выигрыш в минутах выглядит скромно, но разработчик проходит этот цикл десятки раз в день, и умножать его нужно ещё на размер команды. Там, где сборка идёт четверть часа, её перестают запускать после каждой мелкой правки: люди копят изменения пачками, а вместе с ними копят и ошибки, которые дешевле было поймать сразу.
Независимость развёртывания. Изменилась реализация хранилища - пересобрать и выкатить придётся только её. Остальная система не затронута.
Здесь экономия не на сборке, а на проверках и риске. Выкатывая один модуль, вы проверяете один модуль, а не всю систему; при отказе откатываете тоже один. Объём регрессионного тестирования и площадь возможной поломки задаются не размером правки, а размером того, что уезжает в продакшен. Монолит берёт полную цену проверки за любое, даже однострочное изменение - оттого релизы в таких системах выходят редко, крупными партиями и с долгой стабилизацией.
Независимость разработки. Модули, развёртываемые по отдельности, пишутся тоже по отдельности - разными людьми и разными командами. Договорились об интерфейсе, и дальше каждый работает у себя, не ожидая соседей.
Сокращается согласование. Его стоимость растёт не от числа людей, а от числа мест, где их работа пересекается. Пока модули связаны напрямую, каждый новый человек приносит не только пару рук, но и новые точки пересечения с чужим кодом. Интерфейс сводит эти переговоры к разовой договорённости: условились один раз - дальше две команды идут параллельно, не блокируя друг друга.
Оговорюсь: конкретных цифр здесь не назвать, они зависят от размера системы, частоты релизов и устройства сборки. Но статьи расходов именно эти три, и разговор с руководством стоит вести в них, а не в абстрактном «качестве кода» - ровно как мы обсуждали в первой части.
Есть и четвёртое следствие, о котором мы подробно говорили в предыдущей части. Бизнес-логика, общающаяся с внешним миром только через интерфейсы, проверяется без внешнего мира:
class InMemoryOrderRepository : OrderRepository {
    private val storage = mutableMapOf<OrderId, Order>()
    override fun findById(id: OrderId) = storage[id]
    override fun save(order: Order) { storage[order.id] = order }
}

object SilentNotifications : NotificationSender {
    override fun orderConfirmed(order: Order) = Unit
}

@Test
fun `заказ с пустой корзиной не принимается`() {
    val useCase = PlaceOrder(InMemoryOrderRepository(), SilentNotifications)

    val result = useCase.execute(OrderDraft(items = emptyList()))

    assertTrue(result.isFailure)
}
Ни базы данных, ни контейнера, ни сетевых вызовов. Тест отрабатывает мгновенно и падает лишь тогда, когда сломана сама бизнес-логика. Тестируемость здесь - не отдельная работа, а побочный эффект правильно направленных зависимостей.
Для специалистов с опытом: отделяйте принцип от инструмента. Инверсия зависимости - про направление ссылок в исходном коде. Внедрение зависимостей - про способ передать реализацию в объект, и оно работает через обычный конструктор. Контейнер внедрения зависимостей - механика сборки для больших систем, не более того. Подключив контейнер, инверсии не получишь: если интерфейс объявлен не в том модуле, никакой фреймворк направление стрелок не поменяет.
Заключение
Если собрать главное из этого материала, получится следующее.
Инкапсуляция объектно-ориентированному подходу не принадлежит - скорее наоборот, объектно-ориентированные языки её ослабили. Настоящая граница в проекте на Kotlin или Java проходит по модулю сборки, а не по ключевому слову private.
Наследование существовало и до появления соответствующих языков в виде ручного приёма. Языки сделали его безопасным и удобным, но это улучшение, а не открытие. Вдобавок наследование создаёт самую жёсткую связь между классами, и композиция чаще оказывается удачнее.
Полиморфизм тоже был возможен раньше - через указатели на функции. Но прежде он был слишком опасен для повседневного применения. Языки сделали его дешёвым и проверяемым, и это изменило всё.
Для архитектора объектно-ориентированное программирование означает ровно одно: полный контроль над направлением зависимостей в исходном коде. Любая стрелка разворачивается вставкой интерфейса, и поток управления этому не препятствует.
Из этого контроля вырастает архитектура со сменными модулями, где база данных и пользовательский интерфейс становятся плагинами к бизнес-правилам, а не наоборот. Низкоуровневые детали остаются внутри плагинов и в ядро не просачиваются.
Интерфейс принадлежит тому, кто им пользуется, а не тому, кто его реализует. На этой детали ломаются формальные попытки применить инверсию зависимости. Проверка одна: удалите модуль с реализацией и посмотрите, соберётся ли оставшееся.
И последнее: инвертировать всё подряд незачем. Интерфейс оправдан на границе, за которой лежит внешний мир или реальная альтернатива. Внутри одного слоя он добавляет шума.
Спасибо, что дочитали до конца.
В следующей части мы разберём третью, последнюю парадигму - функциональное программирование. Поговорим о том, почему ограничение на присваивание оказалось не причудой математиков, а ответом на самую дорогую категорию ошибок в современных системах, что такое функциональное ядро в императивной оболочке и почему хранение событий вместо текущего состояния меняет взгляд на устройство данных.
Следите за продолжением.